LLM 13

[LLM] AI 모델도 ‘과외’를 받는다그런데 답안지를 1,600만 번 긁어가면? LLM Distillation 완전정복

LLM · KNOWLEDGE DISTILLATION · MODEL EXTRACTIONAI 모델도 ‘과외’를 받는다그런데 답안지를 1,600만 번 긁어가면?미·중 AI 갈등의 새 키워드가 된 Distillation을 아주 쉽게 시작해서, Teacher–Student 원리와 Reasoning Distillation, Model Extraction, Enterprise 방어까지 내려가 본다.최근 미국 정부와 미국 AI 기업들은 중국계 AI 연구소들이 미국의 frontier model을 대규모로 distill했다고 공개적으로 문제를 제기했다. 처음 들으면 조금 이상하다. 모델을 훔쳤다면 weight를 빼갔다는 뜻일까? 그런데 여기서 말하는 distillation은 대개 weight 파일을 복사하는 것과는 다르다..
LLM 2026.09.10

[LLM] LLM도 입사하면 재교육이 필요하다! Fine-tuning의 수학부터 LoRA·DPO·GRPO, Post-training까지

LLM POST-TRAINING · LoRA · DPO · GRPO · FINANCIAL AI LLM도 입사하면 재교육이 필요하다 Fine-tuning의 수학부터 LoRA·DPO·GRPO, 금융권 Post-training까지 “우리 회사 문서를 학습시키면 모델이 똑똑해질까요?”라는 질문에서 출발해, Gradient Descent와 Cross Entropy부터 QLoRA, Preference Optimization, Reasoning RL, RLVR, Responsible AI, 개인정보보호까지 한 번에 내려가 본다. 어느 월요일 아침, Foundation Model 하나가 금융회사에 입사했다고 상상해보자. ..

LLM 2026.09.09

[LLM] GPT-6 Astra 등장! GPT-5.6과 무엇이 달라졌을까?

GPT-6 · AGENTIC AI · COMPUTER USE · ENTERPRISE AI GPT-6 Astra더 똑똑한 챗봇이 아니라‘업무 실행 엔진’이 되어가고 있다 GPT-5.6과 무엇이 달라졌을까? Benchmark 숫자보다 중요한 변화, 제대로 활용하는 Prompt 방식, Computer Use와 Tool Calling, 비용 함정, 그리고 출시 직후 사용자들의 엇갈린 후기까지. 2026년 9월 3일 OpenAI가 GPT-6 Astra를 공개했다. 새 GPT가 나올 때마다 익숙한 질문이 반복된다. “그래서 GPT-5.6보다 몇 % 더 똑똑한데?” 그런데 이번에는 이 질문만으로는 변화의 핵심을 놓치기 쉽다. GPT-6 Astr..

LLM 2026.09.08

[AI] Claude Pro 결제했다. 이제 진짜 뽕 뽑아보자!

CLAUDE PRO · CLAUDE CODE · COWORK · PROJECTS · SKILLS · AUTOMATION CLAUDE PRO POWER-USER PLAYBOOK · 2026-09-06 월 $20를 “질문 많이 하기”에 쓰지 말자.일을 없애는 데 쓰자. 5시간 사용량 Window부터 Sonnet/Opus 라우팅, Projects·Research·Cowork·Skills·Claude Code·Scheduled Task까지. Claude Pro를 실제 업무 시스템으로 바꾸는 실전 가이드. 결제 버튼을 눌렀다. 카드에서 $20이 빠져나갔다. 결제 직후“이제 진짜 생산성 10배다.”3주 뒤“근데 난 주로 맛집을 물어봤는데?”..

LLM 2026.09.06

[LLM] 왜 “정확히 이렇게 해줘”라고 하면 AI가 말을 잘 들을까? Prompt Engineering의 확률적 정체

PROMPT ENGINEERING · IN-CONTEXT LEARNING · PRODUCTION LLM · AI SECURITYDEEP DIVE · 2026-09-05왜 “정확히 이렇게 해줘”라고 쓰면AI가 갑자기 말을 잘 들을까?Prompt Engineering의 확률적 정체.Next-token prediction, Pretraining Data, Instruction Tuning, In-Context Learning부터 Production Prompt Architecture까지.프롬프트 엔지니어링을 배우다 보면 이상한 경험을 한다.그냥 “이 문서를 요약해줘”라고 했을 때는 결과가 애매했는데,“핵심 사실만 5개, 각 항목 2문장 이하, 추측 금지, 근거 없으면 모른다고 표시”라고 쓰면 갑자기 모델이 정..

LLM 2026.09.05

[LLM] 콜센터에 AI를 심어보자 — STT부터 RAG, Agent Assist까지 실시간 상담 Copilot Deep Dive

CONTACT CENTER AI · STT · RAG · AGENT ASSIST · FINANCIAL AI콜센터에 AI를 심어보자귀로 듣고, RAG로 찾고, 상담원 옆에서 속삭이는 실시간 Copilot콜센터 AI를 아주 단순하게 그리면 이렇다. 고객의 말을 듣고(STT) → 무슨 질문인지 이해하고(Intent) → 필요한 정보를 찾고(RAG) → 상담원에게 짧게 보여준다. 그런데 실제 운영에서는 이 네 단계 사이에 화자 구분, 대화 맥락, 고객 계약정보, 약관 버전, 개인정보, latency, audit가 끼어든다. 그래서 Contact Center AI는 “STT + LLM”이 아니라 실시간으로 움직이는 AI pipeline에 가깝다.이 글의 한 줄 Thesis콜센터 AI의 품..

LLM 2026.09.04

[LLM] LLM Evaluation A to Z — “평가 그거 현업이 다 하나요?” Dataset부터 LLM-as-a-Judge까지

LLM 서비스를 만들다 보면 결국 이 질문을 만난다.THE EVAL QUESTION“그래서 이 버전이진짜 더 좋아진 거 맞아?”Prompt를 바꿨다. 모델을 바꿨다. RAG chunking을 바꿨다. reranker도 붙였다.샘플 몇 개를 직접 물어보니 좋아 보인다.그런데 Production으로 올려도 될까?여기서 많은 팀이 갑자기 Excel을 연다.질문 1 → 정답 O질문 2 → 애매질문 3 → 정답 O...Accuracy = 82%그런데 이 82%는 생각보다 별 의미가 없을 수도 있다.평가셋이 실제 사용자 질문을 대표하는가?쉬운 질문만 몰려 있지 않은가?정답 기준은 누가 만들었는가?RAG가 못 찾은 건지 LLM이 못 답한 건지 구분되는가?82%와 85%의 차이가 진짜 개선인가, 표본 잡음인가?LLM ..

LLM 2026.09.04

[LLM] LLM은 갑자기 나타나지 않았다! (기초 다지기)

AI HISTORY · DEEP DIVELLM은 어느 날 갑자기 태어나지 않았다 언어를 확률표로 세던 시대에서 시작해, RNN은 기억을 만들었고, LSTM은 기억에 문을 달았고, Attention은 “필요할 때 다시 보자”고 했고, Transformer는 아예 순환 구조를 버렸다. 그 위에 pre-training, scaling, RLHF, RAG, MoE, reasoning, agent가 한 층씩 올라갔다. 이 글은 모델 이름을 외우는 연표가 아니라 “왜 다음 기술이 필요했는가”를 따라가는 이야기다. rubrub · 2026. 09. 04 · Visual Long Read · 그림으로 읽는 약 35~45분먼저 한 문장으로. LLM의 역사는 결국 “언어를 어떻게 기억할 것인가 →..

LLM 2026.09.04

[LLM] RAG 고도화 여정기 — Naive RAG에서 GraphRAG까지, 그런데 시작은 Ingestion이다

처음 RAG를 붙였을 때 꽤 많은 팀이 비슷한 반응을 한다.FIRST RAG EXPERIENCE“어...? 생각보다 별론데?”문서를 잘게 자르고, embedding해서 Vector DB에 넣고, 질문과 가까운 chunk 몇 개를 LLM에게 넘기면 꽤 그럴듯한 답이 나올 것 같았다.실제로는 제품명 하나를 못 찾고, 다른 버전의 약관을 가져오고, 표는 반쯤 깨지고, 문장의 주어를 잃어버린 chunk가 검색되고, 정답 문서가 11등이라 Top-10에서 잘리는 일이 생긴다.그래서 RAG를 운영하다 보면 자연스럽게 Hybrid Search, Reranker, Query Rewrite, GraphRAG 같은 기법을 하나씩 만나게 된다.그런데 요즘 내가 더 강하게 느끼는 건 따로 있다.MY TAKERAG에서 Retr..

LLM 2026.09.04

[LLM] GraphRAG 최신 트렌드 — 벡터 검색이 놓치는 관계와 현실적인 타협점

GRAPH RAG · HYBRID RETRIEVAL · FINANCIAL AI GraphRAG 최신 트렌드벡터 검색이 놓치는 ‘관계’를 잡는다 RAG를 운영하다 보면 이런 질문을 만난다. “두 문서가 서로를 참조하는데, 왜 검색 결과에서는 남처럼 나오지?” 임베딩은 문장이 얼마나 비슷한지는 잘 찾지만, 누가 누구에게 적용되고 어떤 조항을 거쳐 결론에 도달했는지는 모른다. GraphRAG는 그 틈을 메운다. 다만 모든 문서를 거대한 지식 그래프로 만드는 순간, 정확도보다 먼저 비용과 운영 난도가 우리를 찾아온다. 먼저 결론 최신 실무 방향은 Vector RAG를 GraphRAG로 교체하는 것이 아니라, Hybrid Search를 기본값으로 두고 관계 추론이 필요한 질문만 Graph 경로로..

LLM 2026.09.04

[LLM] LangSmith와 LLM 옵저버빌리티 — 에이전트도 로그를 남겨야 한다

LLM 애플리케이션을 운영하면서 제일 답답한 순간은 모델이 틀렸을 때가 아니었다. THE REAL DEBUGGING PROBLEM “왜 이런 답이 나왔지?” 같은 질문을 다시 넣어도 결과가 달라지고, 검색 결과·프롬프트·Tool Call·모델 호출이 여러 단계로 얽혀 있다면 일반적인 application log 몇 줄로는 원인을 찾기 어렵다. 전통적인 소프트웨어라면 로그와 stack trace를 따라가면 된다. 하지만 Agent는 비결정적(non-deterministic)이고, 한 번의 요청 안에서 retrieval, LLM, tool, sub-agent, external API가 연속해..

LLM 2026.09.03

[LLM] LangChain, 이제 "프레임워크"라고 부르기엔 너무 커졌다

처음 LangChain을 접했을 때의 이미지는 꽤 단순했다. Prompt → LLM → Parser → Retriever → 또 LLM 복잡한 LLM 호출을 레고처럼 연결해주는 Python framework. 그런데 2026년의 LangChain을 보면 이야기가 꽤 달라졌다. 이제 관심사는 "LLM API를 얼마나 편하게 호출할까?"가 아니다. PRODUCTION AGENT의 진짜 질문 Agent가 30분 동안 일하다가 죽으면 어디서 다시 시작하지? 이미 외부 API를 호출했는데 retry해도 괜찮나? Agent A가 Agent B에게 일을 넘겼다면 누가 무슨 데이터를 봤지? Pro..

LLM 2026.09.03

[LLM] LLM Foundations

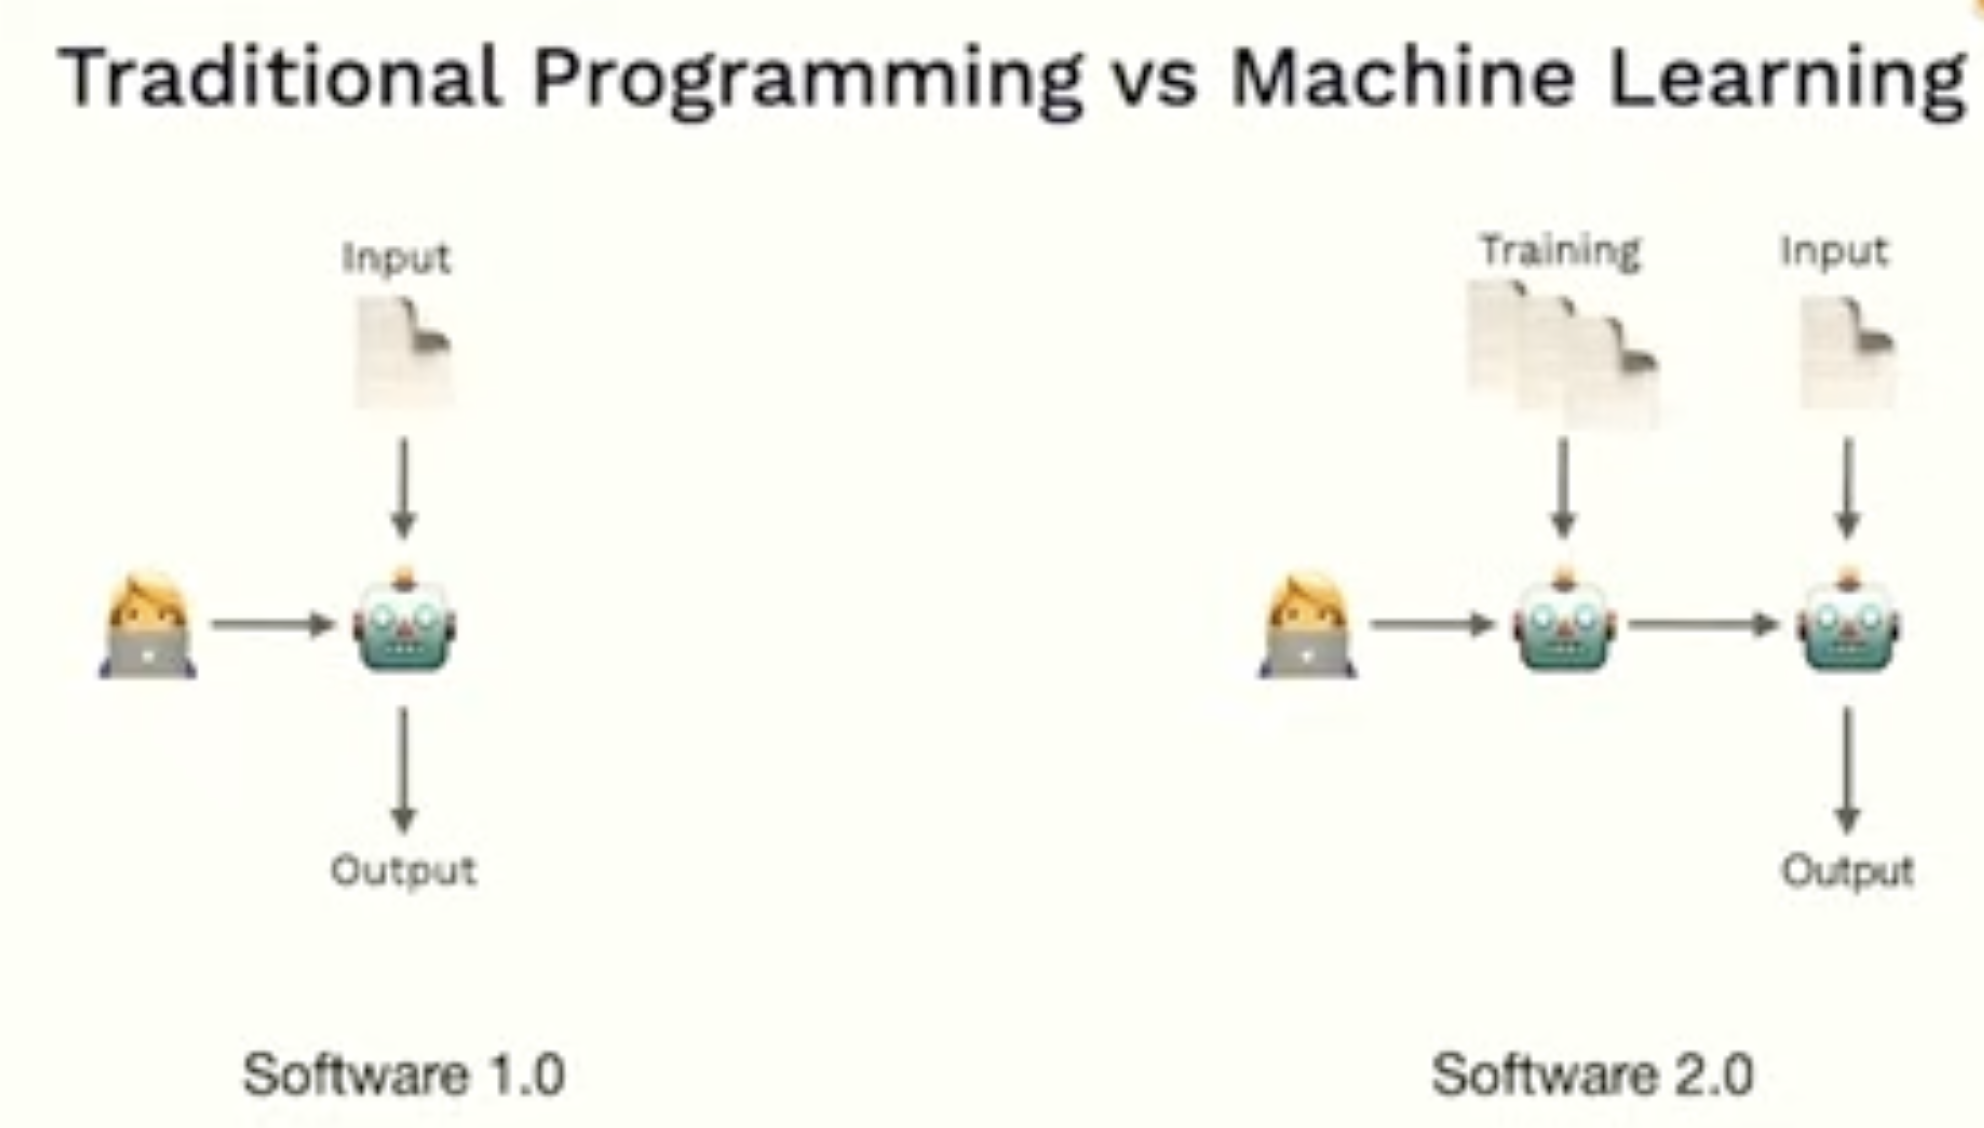
2025-07-07INTROAI 공부하다가 LLM 기초 정리하기! 기초라고 하지만, 깊이 있는 내용을 다루고자 한다. The Full Stack에서 강의한 LLM Foundations 영상을 참고했다. 내용은 머신러닝 기초 → Transformer 블록 → 대표 LLM 군 → 운영 Tips 까지 포함한다. 1. Software 2.0 사고방식 — “데이터가 코드를 빚는다” 구분Software 1.0Software 2.0코드사람이 직접 로직 작성“학습 로봇”만 작성 → 데이터가 로직 생성검증유닛 테스트‧에지 케이스 명시Train / Val / Test 스플릿 + 지표 모니터링버전Git commit 단위데이터 스냅샷 + 파라미터 파일핵심 키워드:학습 종류Unsupervised: 패턴·생성 (ex. GPT ..

LLM 2025.07.07