처음 LangChain을 접했을 때의 이미지는 꽤 단순했다.
복잡한 LLM 호출을 레고처럼 연결해주는 Python framework.
그런데 2026년의 LangChain을 보면 이야기가 꽤 달라졌다.
이제 관심사는 "LLM API를 얼마나 편하게 호출할까?"가 아니다.
PRODUCTION AGENT의 진짜 질문
Agent가 30분 동안 일하다가 죽으면 어디서 다시 시작하지?
이미 외부 API를 호출했는데 retry해도 괜찮나?
Agent A가 Agent B에게 일을 넘겼다면 누가 무슨 데이터를 봤지?
Prompt 하나 바꿨다가 성능이 떨어지면 어디서 잡지?
그리고 보안팀이 "이 Agent가 왜 이 Tool을 호출할 권한이 있죠?"라고 물으면?
최근 LangChain이 만드는 것들을 보면 이 질문들에 답하려는 방향이 꽤 선명하다.
Agent Runtime + Harness + Observability + Governance를 포함하는 Agent Engineering Stack으로 진화하고 있다.
01. LangChain 하나라고 생각하면 이제 헷갈린다
지금 생태계를 단순화해서 보면 역할은 대략 이렇게 나뉜다.
특히 재미있는 것은 LangGraph다.
예전에는 "Agent workflow를 graph 형태로 짜는 라이브러리" 정도로 받아들이기 쉬웠는데, 실제로는 점점 Agent execution runtime에 가까운 역할을 맡고 있다.
02. Chain의 시대와 Agent의 시대는 장애의 종류부터 다르다
기존의 RAG application은 비교적 단순했다.
↓
Retrieve
↓
LLM
↓
Response
중간에 실패하면 대부분 요청 전체를 다시 실행해도 큰 문제가 없었다.
Agent는 다르다.
↓
Planner
↓
Retrieve
↓
Tool Call ── DB / API / Search
↓
Sub Agent
↓
Human Approval
↓
External System
↓
Reason Again ↺
예를 들어 8번째 단계에서 오류가 났다고 해보자.
처음부터 다시 실행하면 이미 결제 API를 호출했을 수도 있고, DB를 변경했을 수도 있고, 메일이나 메시지를 보냈을 수도 있다.
여기서부터 LLM application이 갑자기 distributed system 냄새를 풍기기 시작한다.
LangGraph의 persistence layer는 graph state를 checkpoint로 저장한다. 그래서 실행 중간에 멈췄다가 이어가거나, 사람이 승인한 뒤 다시 시작하거나, 실패 직전 상태에서 복구하는 패턴이 가능해진다.
이제는 "실행 상태를 어떻게 보존하고, 실패를 어떤 의미론으로 복구할 것인가?"의 문제다.
03. LangGraph 1.1 — Type Safety가 왜 중요하지?
2026년 3월 LangGraph 1.1에는 type-safe streaming과 invoke, Pydantic/dataclass coercion 같은 변화가 들어왔다.
얼핏 보면 개발자 편의 기능처럼 보인다. 하지만 Agent graph의 node가 많아지기 시작하면 이야기가 달라진다.
예를 들어 이런 graph가 있다고 해보자.
중간 node의 output schema가 바뀌었는데 모든 값이
dict[str, Any]
로 흘러다닌다면 문제를 실제 runtime에서야 발견할 수 있다.
Type information이 유지되면 IDE와 static analysis 단계에서 훨씬 일찍 문제를 잡을 수 있다.
결국 Agent code도 점점 "prompt 몇 개 붙인 Python script"가 아니라 "schema contract를 가진 application"으로 변하고 있다.
04. 요즘 더 재미있는 단어: Agent Harness
2026년 LangChain 쪽 글을 보다 보면 Harness라는 단어가 굉장히 자주 나온다.
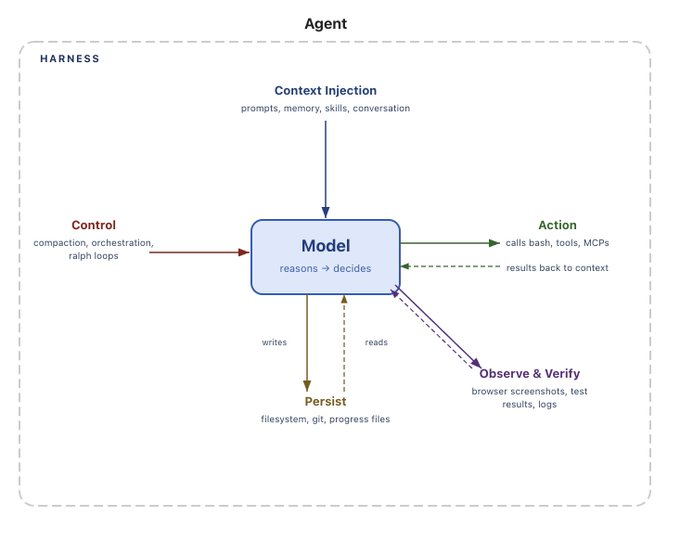
모델 바깥에서 그 모델을 실제로 일하게 만들어주는 모든 것이 Harness에 가깝다.
- System Prompt
- Tools / MCP / Skills
- Filesystem / Sandbox
- Memory
- Context compression
- Sub-agent orchestration
- Middleware / Hooks
- Verification loop
이 관점이 꽤 중요하다.
모델 benchmark만 비교해놓고 "모델 A가 모델 B보다 Agent 성능이 좋다"고 말하기가 점점 어려워진다는 뜻이기 때문이다.
같은 모델이라도 어떤 tool을 주는지, context를 어떻게 compact하는지, sub-agent를 어떻게 쪼개는지, 결과 검증을 어떤 loop으로 넣는지에 따라 전체 성능이 크게 달라질 수 있다.
05. Deep Agents — 또 하나의 Agent Framework일까?
처음 이름만 보면 "LangChain에서 Agent framework를 또 만들었나?" 싶다.
하지만 Deep Agents는 오히려 Agent Harness를 패키징한 층으로 보는 편이 이해하기 쉽다.
├── Research Agent
├── Coding Agent
├── Document Agent
└── Validation Agent
+ Filesystem
+ Planning
+ Context Management
+ Memory
+ Skills
0.5 버전에서는 async subagent가 들어왔다.
즉 supervisor가 오래 걸리는 sub-agent를 실행한 뒤 결과가 나올 때까지 멍하니 block되는 대신, task를 background에 보내고 다른 작업을 계속할 수 있다.
├──▶ Research Agent ──────────┐
├──▶ Risk Agent ────────┐ │
└──▶ Continue work │ │
◀────┴─────┘
그리고 8월 기준 Deep Agents는 이미 v0.7까지 올라왔고, LangSmith에서는 Managed Deep Agents도 Public Beta에 들어갔다.
이제 "Agent 코드 짜기"에서 끝나는 게 아니라 오래 실행되는 Agent를 어떻게 package하고 deploy하고 operate할 것인가까지 영역이 확장된 셈이다.
06. NVIDIA와 붙은 것도 그냥 모델 Integration 이야기가 아니다
2026년 3월 LangChain은 NVIDIA와 enterprise agent platform 협력을 발표했고, Nemotron Coalition에도 합류했다.

여기서 중요한 건 "Nemotron을 LangChain에서 호출할 수 있다"가 아니다.
Agent 성능 최적화 단위가 모델 하나에서 전체 system으로 이동하고 있다는 점이 더 흥미롭다.
↓
Prompt / Context
↓
Tool Strategy
↓
Agent Harness
↓
Execution Runtime
↓
Inference Runtime
7월에는 이 방향이 NemoClaw Deep Agents Blueprint로 더 구체화됐다. LangChain의 Deep Agents harness, NVIDIA Nemotron, OpenShell secure runtime을 같이 묶어 model + harness + runtime + eval을 함께 최적화하는 방향이다.
07. 진짜 Enterprise 냄새는 LangSmith 쪽에서 난다
Agent가 사내 PoC를 벗어나 production으로 넘어가면 질문이 바뀐다.
↓
"누가 무엇을 호출했나요?"
"어떤 데이터에 접근했나요?"
"Prompt와 configuration은 누가 바꿨나요?"
"비용은 누가 얼마나 썼나요?"
"문제가 발생한 실행을 다시 재현할 수 있나요?"
이쯤 되면 AI 문제가 아니라 Platform Engineering + Governance 문제다.
ABAC — Resource 단위 접근제어
LangSmith는 RBAC에 더해 resource tag 기반 ABAC를 지원한다.
Region = KR
Team = Claims
DataClass = Internal
그리고 이런 태그를 기준으로 특정 role이 어떤 project, dataset, prompt, deployment 등에 접근할 수 있는지를 제한한다.
Audit Log — 결국 "누가 뭘 바꿨나"를 증명해야 한다
Audit Log는 organization 설정, credential, workspace 등 관리 변경 이벤트에 대해 actor, timestamp, operation, affected resource, 성공 여부 등을 기록한다.
↓
changed WHAT
↓
WHEN
↓
on WHICH RESOURCE
↓
SUCCESS / FAILURE
현재 공식 문서 기준 Audit Log retention은 최대 400일이다.
금융권에서는 이런 기능이 생각보다 중요하다.
AI Governance 문서를 몇십 장 만들어놓는 것도 필요하지만, 실제 운영 환경에서 "누가 production 설정을 변경했고 그것을 사후 추적할 수 있는가"가 훨씬 직접적인 통제가 되기 때문이다.
08. 결국 LLM Gateway까지 왔다
2026년 8월에는 LangSmith LLM Gateway가 Public Beta에 들어갔다.
Agent와 Model Provider 사이에 gateway를 두고 cost control, rate limit, fallback, sensitive data handling 같은 정책을 적용하는 구조다.
Rate Limit
Model Fallback
Sensitive Data Handling
Centralized Model Access
개인적으로 이 방향이 재밌는 이유는 AI Governance가 문서에서 runtime policy로 이동하기 때문이다.
예를 들어 Agent가 loop에 빠져 모델을 계속 호출하고 있다면, 다음 달 cloud bill을 보고서야 발견하는 것보다 gateway에서 budget/rate policy로 막는 게 훨씬 engineering스럽다.
09. 그래서 금융권/폐쇄망에서는 어떻게 가져갈까
여기부터는 조금 냉정하게 봐야 한다.
Managed Deep Agents, Sandbox, Gateway가 아무리 편해도 고객 데이터나 내부 정보가 외부 SaaS control plane으로 나가는 구조라면 금융회사에서는 그 자체가 긴 보안 검토의 시작점이 될 수 있다.
그래서 Azure 기반 금융 환경이라면 오히려 다음처럼 layer를 나눠보는 편이 현실적이다.
State · Checkpoint · HITL · Agent Flow
PostgreSQL / Vector DB
Internal API
HITL
Private Endpoint
vLLM / GPU
LangSmith도 Azure AKS 기반 full self-hosted 구성이 가능하다. 공식 Azure guide에는 AKS, PostgreSQL, Redis, Blob Storage, Key Vault 등을 이용하는 구조가 정리되어 있다.
다만 Self-hosted = 무조건 완전 폐쇄망은 아니다.
이런 부분은 PoC 단계에서는 거의 보이지 않는다.
그러다 architecture review에 들어가는 순간 꼭 나온다.
네. 그 질문이 나온다.
10. 그리고 Agent에게 절대 맡기면 안 되는 것
예를 들어 고객별 보험계약 정보를 조회한다고 해보자.
LLM에게 "이 사용자가 이 계약서를 볼 수 있는지 판단해줘" 라고 시키는 순간 구조가 잘못됐다.
Authorization은 deterministic해야 한다.
금융권 Agent에서 LLM은 굉장히 똑똑한 decision component가 될 수 있다.
하지만 보안의 Root of Trust가 되어서는 안 된다.
11. 결국 LangChain이 만드는 것은 "Agent용 Application Server"에 가까워지고 있다
초기 LangChain의 성공은 abstraction이었다.
하지만 지금 풀고 있는 문제는 다르다.
실패하면 어디서 복구할 것인가.
행동을 어떻게 관찰할 것인가.
권한을 어떻게 제한할 것인가.
품질을 어떻게 평가할 것인가.
비용을 어떻게 통제할 것인가.
즉 관심사가 Model → System으로 이동하고 있다.
앞으로 모델은 계속 좋아질 것이다.
그런데 아무리 좋은 모델을 붙여도,
Tool 권한 관리 안 됨
Trace 없음
Eval 없음
Retry 이상함
비용 통제 없음
이 상태라면 production에서는 굉장히 비싼 사고 제조기가 될 수 있다.
역설적으로 모델 바깥의 시스템 엔지니어링이 더 중요해진다.
이제 "어떤 LLM을 썼느냐"만큼 그 LLM 주위에 어떤 Harness와 Runtime을 구축했느냐가 Agent 제품의 품질을 결정한다.
LangChain이 프레임워크에서 플랫폼으로 이동하는 것도 결국 같은 이유라고 본다.
그리고 엔지니어 입장에서는 이 방향이 꽤 재미있다.
LLM을 잘 쓰는 능력과 함께, 다시 distributed system, platform engineering, observability, IAM, security 같은 오래된(?) 문제들이 중요해지고 있기 때문이다.
AI가 발전할수록 다시 엔지니어링의 시간이 오고 있다.
References
01. LangChain — March 2026 Newsletter
02. The Anatomy of an Agent Harness
03. Deep Agents v0.5
04. LangChain × NVIDIA Enterprise Agentic AI Platform
05. NemoClaw Deep Agents Blueprint
06. August 2026 LangChain Newsletter
08. LangSmith Attribute-Based Access Control
'LLM' 카테고리의 다른 글
| [LLM] LLM은 갑자기 나타나지 않았다! (기초 다지기) (0) | 2026.09.04 |
|---|---|
| [LLM] RAG 고도화 여정기 — Naive RAG에서 GraphRAG까지, 그런데 시작은 Ingestion이다 (0) | 2026.09.04 |
| [LLM] GraphRAG 최신 트렌드 — 벡터 검색이 놓치는 관계와 현실적인 타협점 (0) | 2026.09.04 |
| [LLM] LangSmith와 LLM 옵저버빌리티 — 에이전트도 로그를 남겨야 한다 (0) | 2026.09.03 |
| [LLM] LLM Foundations (3) | 2025.07.07 |