LLM 애플리케이션을 운영하면서 제일 답답한 순간은 모델이 틀렸을 때가 아니었다.
검색 결과·프롬프트·Tool Call·모델 호출이 여러 단계로 얽혀 있다면
일반적인 application log 몇 줄로는 원인을 찾기 어렵다.
전통적인 소프트웨어라면 로그와 stack trace를 따라가면 된다. 하지만 Agent는 비결정적(non-deterministic)이고, 한 번의 요청 안에서 retrieval, LLM, tool, sub-agent, external API가 연속해서 움직인다.
그래서 요즘 LLM 운영에서 중요한 것은 단순한 logging이 아니라 “Agent가 어떤 경로로 행동했고, 그 행동이 좋은 행동이었는지를 재구성할 수 있는가”다.
Eval은 “그 결과가 좋은가”를 판단한다.
Production LLM 시스템에는 둘 다 필요하다. Trace만 있는 Agent는 “볼 수는 있지만 채점할 수 없는 시스템”에 가깝다.
01. LLM Observability는 그냥 로그를 예쁘게 보는 도구가 아니다
전통적인 observability에는 보통 Logs · Metrics · Traces가 있다. LLM observability도 기본 뼈대는 같다. 다만 관찰해야 할 단위가 훨씬 의미론적이다.
LangSmith에서는 model call이나 tool invocation 같은 하나의 작업을 Run으로 기록하고, OpenTelemetry 관점에서는 이를 span과 비슷하게 볼 수 있다. 여러 run이 모여 하나의 trace가 되고, 여러 turn의 trace가 thread를 이룬다.
Agent 시대에는 이 마지막 trajectory가 특히 중요하다. 최종 답변이 맞았더라도 엉뚱한 Tool을 세 번 호출하고 우연히 맞았을 수 있기 때문이다.
02. HTTP 200이라고 Agent가 성공한 것은 아니다
일반 API에서 꽤 유용한 지표는 명확하다.
Error rate ?
P95 latency ?
CPU / Memory ?
그런데 LLM application은 모두 정상이어도 실패할 수 있다.
Latency 2.8s ✓
Tool call succeeded ✓
JSON valid ✓
그런데 답변은 틀림 ✗
이것이 LLM observability에 Eval이 붙는 이유다.
시스템 관점의 성공과 의미론적 성공이 다르다. Agent를 운영하려면 latency와 error rate뿐 아니라 groundedness, task success, tool correctness, policy adherence 같은 품질 신호도 같이 봐야 한다.
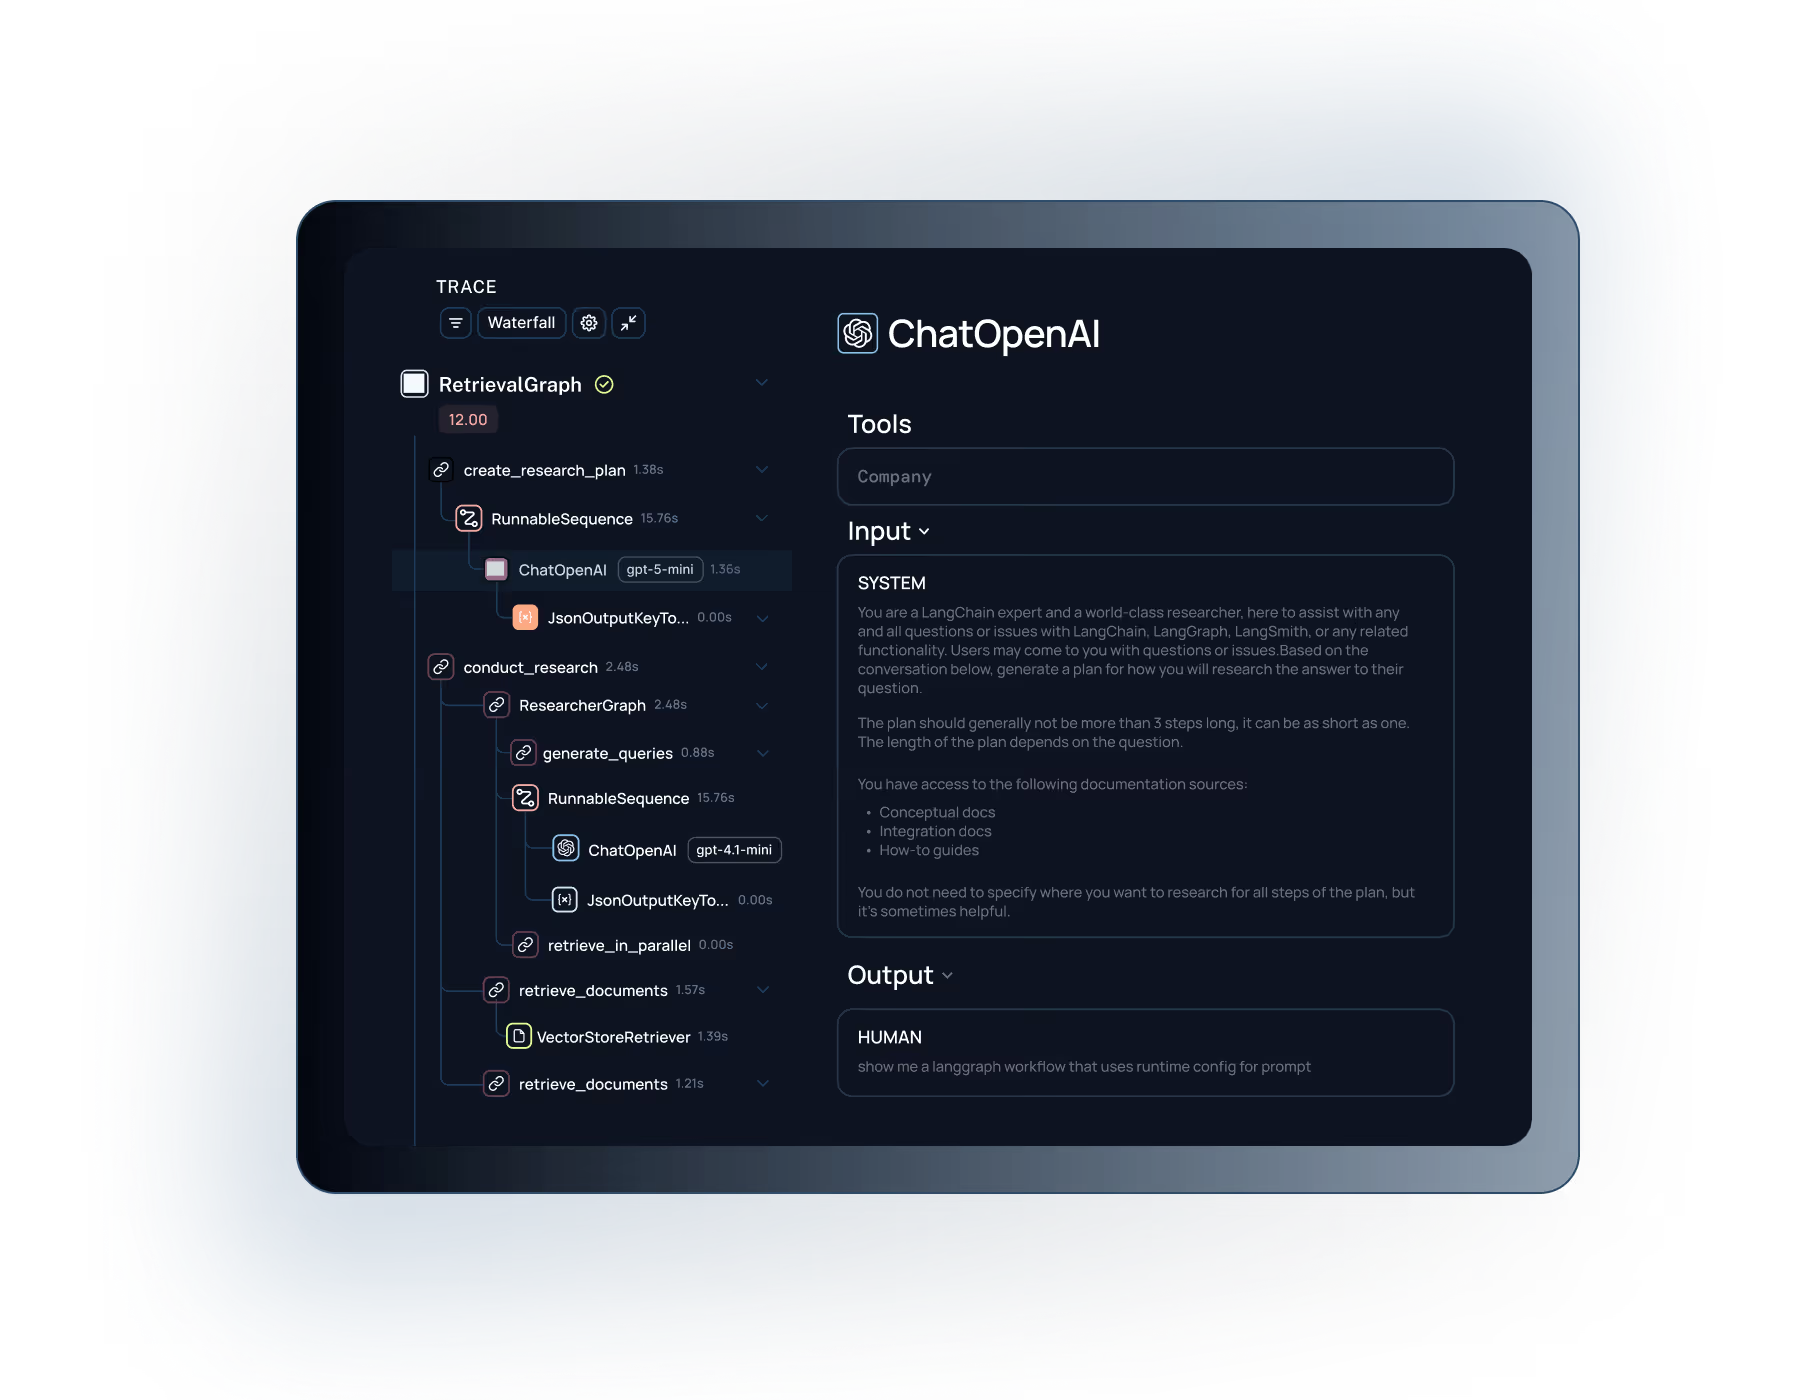
03. Trace 하나를 열었을 때 내가 보고 싶은 것
RAG + Agent 구조라면 개인적으로 최소한 아래 정도는 한 trace 안에서 연결되어 있어야 한다고 본다.
├── Intent / Router [32ms]
├── Retrieval [86ms]
│ ├── query
│ ├── document_id / version
│ └── similarity / rerank score
├── LLM Call [1.4s · 2,180 tokens]
├── Tool: policy_lookup [182ms]
├── LLM Call [923ms · 1,240 tokens]
└── Final Response
Feedback
├── groundedness = 0.91
├── tool_correctness = 1.0
└── user_feedback = negative
여기에는 단순한 input/output 외에도 model/provider, prompt version, token usage, latency, retry 횟수, retrieved document ID, tool name, evaluator score, application version 같은 metadata가 붙어야 한다.
04. 계측 자체는 생각보다 간단하다
LangChain/LangGraph를 쓰면 tracing을 거의 자동으로 붙일 수 있고,
framework를 쓰지 않아도 LangSmith SDK의 @traceable이나
provider wrapper를 사용할 수 있다.
중요한 것은 decorator 자체가 아니라 trace boundary를 어디에 잡는가다.
“모든 Python 함수”를 trace하는 것이 아니라 품질·비용·보안 관점에서 원인을 분리하고 싶은 의미 있는 operation을 span으로 잡는 편이 좋다.
05. 그런데 Tracing은 독심술이 아니다
흔히 “Agent의 중간 추론을 전부 볼 수 있다”고 표현하지만, 이 표현은 조금 조심할 필요가 있다.
Observability가 보는 것은 기본적으로 애플리케이션이 관측할 수 있도록 노출한 state, messages, tool calls, inputs/outputs, metadata다. 모델 내부의 hidden chain-of-thought를 마법처럼 읽어내는 것이 아니다.
06. Trace 다음은 Eval — 볼 수 있는 것과 잘하는 것은 다르다
여기서 LLM observability가 일반 APM과 가장 크게 갈라진다.
어떤 tool을 호출했나?
어디서 4초가 걸렸나?
token을 어디서 많이 썼나?
tool 선택이 맞았나?
업무가 실제로 완료됐나?
정책을 위반하지 않았나?
LangSmith의 evaluation도 크게 Offline과 Online으로 나뉜다.
| 구분 | Offline Eval | Online Eval |
|---|---|---|
| 언제? | 배포 전 / CI | Production |
| 입력 | Curated dataset + reference | Live traces / threads |
| 목적 | Regression / benchmark / backtest | Quality monitoring / anomaly detection |
| 핵심 질문 | “이 변경을 배포해도 되나?” | “실사용에서 지금도 잘하고 있나?” |
07. LLM-as-a-Judge — 그리고 Judge도 평가해야 한다
자연어 응답은 정답 하나로 비교하기 어렵다. 그래서 LLM을 evaluator로 사용해 groundedness, correctness, tone, policy adherence 등을 채점하는 LLM-as-a-Judge가 많이 쓰인다.
그런데 여기서 또 하나의 LLM을 붙였다고 문제가 끝나는 것은 아니다.
Prompt에 민감하고, 표현 방식에 bias가 생길 수 있고, 사람이 중요하게 보는 기준과 다른 기준을 학습했을 수도 있다.
그래서 처음부터 모든 것을 LLM judge에게 맡기기보다 역할을 나누는 편이 낫다.
Required field exists? → Code Eval
Tool allowed? → Code / Policy
Answer grounded? → LLM Judge
Helpful / nuanced? → LLM Judge + Human sample
그리고 judge score를 운영 지표로 쓰기 전에는 사람이 라벨링한 작은 validation set과 비교해서 agreement를 먼저 확인하는 게 좋다.
08. 재미있는 숫자: 다들 보고는 있는데, 아직 많이 채점하지는 않는다
LangChain이 2026년 1,300명 이상의 업계 종사자를 대상으로 조사한 State of Agent Engineering 결과가 꽤 흥미롭다.
한마디로 요약하면 이렇다.
“Agent를 지속적으로 채점하는 팀”은 아직 훨씬 적다.
그래서 현실적인 도입 순서는 Tracing → Offline Eval → Online Eval이 맞다고 본다. 처음부터 production traffic 전체에 비싼 judge model을 붙일 필요도 없다. LangSmith도 online evaluator에 filter와 sampling rate를 둘 수 있다.
09. 중요한 것은 Dashboard가 아니라 Feedback Loop다
Observability 도구의 최종 목적은 예쁜 dashboard가 아니다.
Production에서 발견한 실패 케이스를 dataset에 넣고, 다음 prompt/model/retrieval 변경 때 regression test로 다시 실행하는 구조가 되어야 한다.
이게 만들어지면 “프롬프트를 좀 바꿨는데 느낌상 좋아진 것 같다”에서 “이 변경으로 Claims FAQ dataset의 groundedness는 +7%, latency는 +11%, cost는 -4%” 같은 engineering conversation으로 바뀐다.
10. Production에서는 Quality · Latency · Cost를 같이 봐야 한다
모델 품질 하나만 좋아도 안 되고, latency 하나만 낮아도 안 된다. Agent는 특히 여러 번의 model/tool call이 쌓여 비용과 지연시간이 폭발하기 쉽다.
LangSmith는 LLM token 비용뿐 아니라 non-LLM run에도 custom cost를 넣을 수 있다. 그래서 검색 API, reranker, 외부 tool 등의 비용을 하나의 trace cost로 합쳐보는 것도 가능하다.
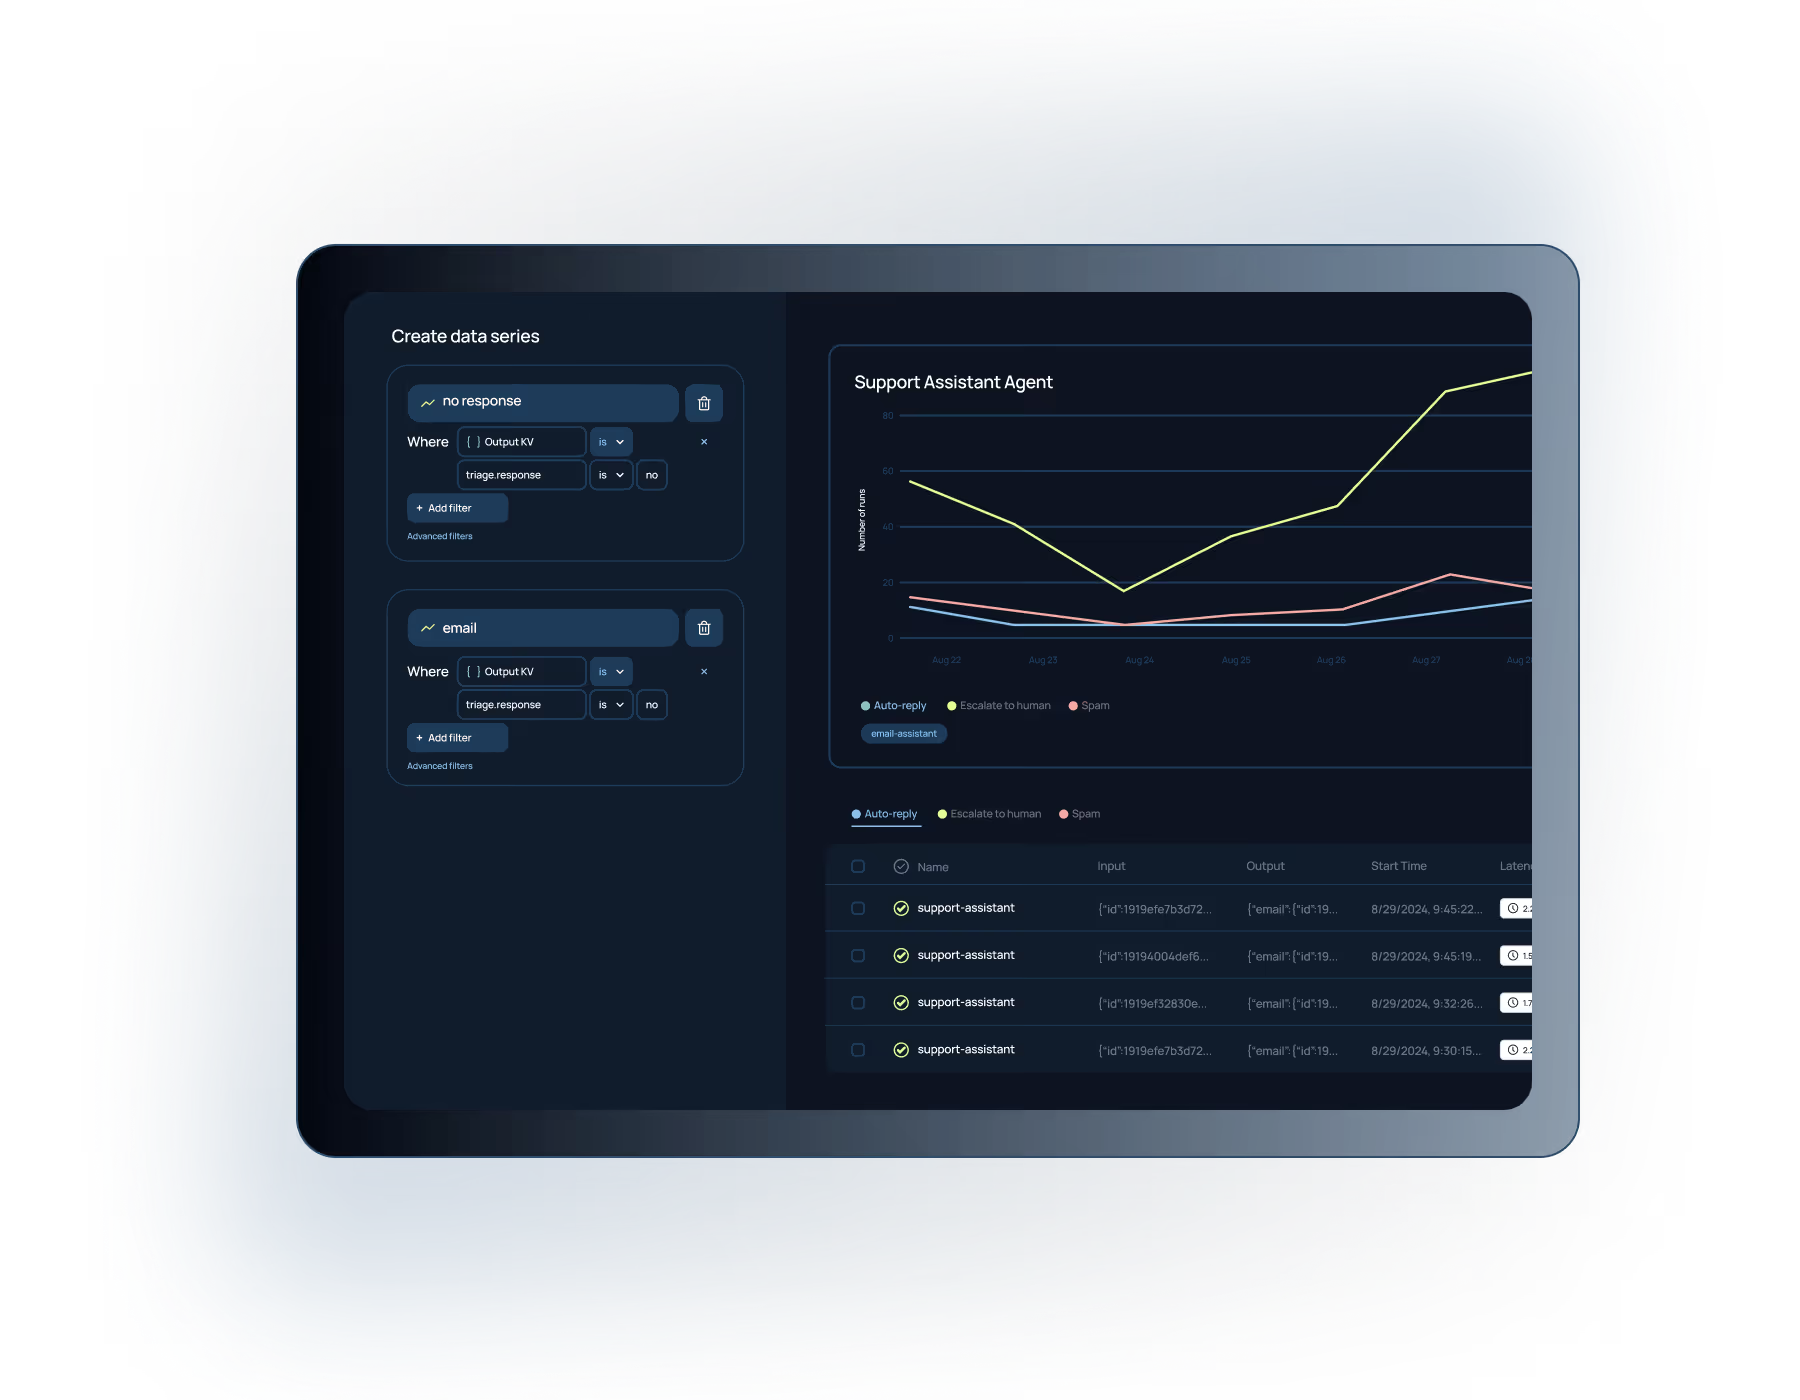
11. Trace가 너무 많아지면 “Trace를 분석하는 AI”가 필요해진다
Agent가 복잡해지면 trace 하나가 수십 개의 run을 포함할 수 있다. 결국 사람이 trace tree를 하나씩 여는 것도 병목이 된다.
LangSmith에는 Polly라는 AI assistant가 있어 trace, run, evaluator feedback이나 conversation thread를 분석하고, 문제 패턴과 사용자의 pain point를 찾는 데 활용할 수 있다.
이 흐름도 꽤 재미있다.
↓
Observability stores traces
↓
Another Agent analyzes the traces
AI를 운영하기 위해 또 다른 AI가 필요한 시대가 되고 있다.
12. 그래서 LangSmith가 무조건 정답인가?
아니다. 이 시장은 생각보다 선택지가 많고, 무엇을 최적화하느냐에 따라 답이 달라진다.
| 도구 | 강점 | Deployment / Openness | 잘 맞는 상황 |
|---|---|---|---|
| LangSmith | Agent trace + eval + monitoring + LangGraph 생태계 | Cloud / BYOC / Enterprise self-hosted · OTel 지원 | LangGraph 중심 Agent platform, end-to-end lifecycle |
| Langfuse | Framework-agnostic observability · prompt · eval | Core MIT OSS self-host · OTel 지원 | 직접 운영, vendor neutrality, OSS 선호 |
| Braintrust | Evals · experiments · regression · CI/CD gating | Cloud + enterprise deployment options · OTel 지원 | PR마다 eval을 돌려 release gate로 쓰고 싶은 팀 |
| Arize AX / Phoenix | LLM + 전통 ML observability · drift · eval · tracing | Phoenix OSS + OpenInference/OTel ecosystem | LLM뿐 아니라 ML model/embedding drift도 같이 운영 |
13. 그리고 나는 OpenTelemetry를 꽤 중요하게 본다
특정 vendor SDK로 application 전체를 단단히 묶으면, 나중에 observability backend를 바꾸고 싶을 때 instrumentation까지 다시 뜯어야 할 수 있다.
그래서 새 Agent platform을 만든다면 최소한 OpenTelemetry export path는 열어두는 편을 선호한다.
OpenTelemetry의 GenAI semantic conventions에는 model, token usage, conversation/agent identifiers, retrieval information, input/output messages 같은 LLM 특화 attribute들이 정의되고 있다.
중요한 점 하나. OTel 문서 자체가 input/output messages나 retrieval query에는 PII 등 민감정보가 포함될 수 있다고 경고한다.
표준화했다고 무조건 다 수집하면 안 된다.
14. 금융권에서 더 중요한 질문: “무엇을 남길까?”보다 “무엇을 절대 남기지 않을까?”
Agent observability를 붙이면 역설적으로 가장 먼저 생기는 보안 문제가 있다.
Trace가 너무 자세하다.
OAuth token · API key · session secret
Tool argument 안의 credential
필요 이상으로 긴 원문 보험 문서
모델의 private/internal reasoning을 의도적으로 수집하려는 설계
금융권에서는 trace pipeline 자체를 하나의 데이터 처리 시스템으로 봐야 한다.
Trace ID · model · latency · doc ID · eval metadata
PII · Secret · Payload policy
Self-host / approved SaaS
Security events
가능하면 user ID는 내부 식별자를 그대로 남기기보다 pseudonymized identifier를 쓰고, retrieval은 문서 원문 전체보다 document ID · version · score 중심으로 남긴다. 실제 prompt/response payload는 use case별 allowlist나 sampling 정책으로 제어하는 편이 안전하다.
Audit Log는 “누가 production prompt/config/access policy를 변경했는가”를 보여준다.
금융권 production이라면 둘 중 하나가 아니라 둘 다 있어야 한다.
15. LangSmith를 금융권에서 쓴다면 내가 먼저 확인할 것
기능 데모보다 아래 질문을 먼저 본다.
02. Cloud / BYOC / Self-host 중 어떤 배포가 가능한가?
03. Data residency와 retention 정책은 무엇인가?
04. Prompt / response masking은 어디서 수행하는가?
05. OTel export/import가 가능한가?
06. RBAC / ABAC / Audit 요구사항은 충족하는가?
07. Online Eval이 어떤 traffic을 sampling하는가?
08. Judge model 호출 데이터는 어디로 가는가?
09. 장애 시 tracing failure가 본 서비스에 영향을 주는가?
10. Trace 삭제 / 보존 / 증적 정책을 누가 관리하는가?
LangSmith Cloud의 현재 문서에는 SaaS trace data가 ingestion 후 180일 보존되는 것으로 안내되어 있다. 반면 보안 요구가 높은 조직을 위해 BYOC와 self-hosted 옵션도 제공한다.
결국 observability 제품 선정은 기능표보다 telemetry data flow를 architecture review에서 설명할 수 있느냐가 더 중요하다.
16. 결국 좋은 LLM Observability는 “실패를 다음 테스트 케이스로 바꾸는 시스템”이다
예전에는 AI 품질 문제를 발견하면 prompt를 열고 조금 고친 다음 다시 몇 번 질문해봤다.
이제 production Agent를 그렇게 운영하기는 어렵다.
Production failure를 다음 regression test로 바꿔주는 feedback engine이다.
Trace에서 실패를 찾고, 그 trace를 dataset으로 만들고, offline eval로 수정안을 검증하고, production에서 online eval로 다시 확인한다.
↓
Evaluate
↓
Diagnose
↓
Improve
↓
Regression Test
↺
모델이 비결정적일수록 운영은 더 정량적이어야 한다.
“Agent도 로그를 남겨야 한다”는 말은 이제 조금 부족하다.
Agent는 행동을 추적할 수 있어야 하고, 그 행동을 지속적으로 채점할 수 있어야 한다.
References
01. LangSmith — Observability concepts
03. LangSmith — Online LLM-as-a-Judge
05. LangChain — State of Agent Engineering 2026
06. OpenTelemetry — GenAI Observability
'LLM' 카테고리의 다른 글
| [LLM] LLM은 갑자기 나타나지 않았다! (기초 다지기) (0) | 2026.09.04 |
|---|---|
| [LLM] RAG 고도화 여정기 — Naive RAG에서 GraphRAG까지, 그런데 시작은 Ingestion이다 (0) | 2026.09.04 |
| [LLM] GraphRAG 최신 트렌드 — 벡터 검색이 놓치는 관계와 현실적인 타협점 (0) | 2026.09.04 |
| [LLM] LangChain, 이제 "프레임워크"라고 부르기엔 너무 커졌다 (0) | 2026.09.03 |
| [LLM] LLM Foundations (3) | 2025.07.07 |