PAPER REVIEW · ICML 2026 OUTSTANDING PAPER · DIFFUSION LLM
자유롭게 생각하게 했더니
오히려 덜 생각했다
〈The Flexibility Trap〉 — Diffusion Language Model의 반전
Zanlin Ni et al. · ICML 2026 Outstanding Paper
요즘 언어 모델의 새로운 후보로 Diffusion Language Model(dLLM)이 뜨고 있다. 기존 LLM이 왼쪽부터 한 글자씩 써 내려간다면, dLLM은 빈칸투성이 문장을 여러 번 고쳐가며 동시에 완성한다. 당연히 더 자유로우니 더 다양한 추론을 할 것 같았다. 그런데 ICML 2026 Outstanding Paper는 정반대의 결과를 보여준다. 자유롭게 생성할수록 어려운 결정을 미뤘고, 그 결과 생각의 갈림길이 더 빨리 닫혔다.
먼저, Diffusion LM은 어떻게 글을 쓸까
GPT 계열의 Autoregressive Model은 앞에서 생성한 토큰을 조건으로 다음 토큰을 하나씩 고른다. 첫 단추를 잘못 끼우면 뒤 문장도 그 선택에 묶인다. 반면 Masked Diffusion LM은 전체 문장을 [MASK]로 시작해, 여러 위치의 토큰을 예측하고 불확실한 위치는 다시 가린 뒤 반복적으로 다듬는다.
따라서 → 우리는 → 식을 → 정리하면 → 42
순서를 바꿀 수 없다. 대신 매 순간의 갈림길을 반드시 통과한다.
[MASK] → 우리는 → [MASK] → 정리하면 → 42
확신 높은 ‘쉬운 칸’부터 채우고 어려운 칸은 나중으로 미룰 수 있다.
이론적으로 dLLM의 생성 경로에는 왼쪽→오른쪽 순서도 포함된다. 그렇다면 가능한 순서가 더 많은 dLLM의 탐색 공간은 AR보다 넓어야 한다. 스도쿠처럼 각 위치가 서로를 강하게 제약하는 문제에서는 실제로 arbitrary order가 유리할 수도 있다. 논문은 바로 이 ‘더 자유로우면 최소한 손해는 아닐 것’이라는 직관을 일반 수학·코딩 추론에서 검증한다.
실험 1: 한 번은 비슷하지만, 여러 번 풀리면 차이가 벌어진다
저자들은 LLaDA-Instruct, Dream-Instruct, LLaDA 1.5를 GSM8K·MATH-500·HumanEval·MBPP에서 평가했다. 핵심 지표는 단일 정답률이 아니라 Pass@k다. 같은 문제를 k번 샘플링했을 때 최소 한 번 정답을 찾을 확률로, 모델이 접근할 수 있는 ‘풀이 공간의 상한’을 보는 지표다.
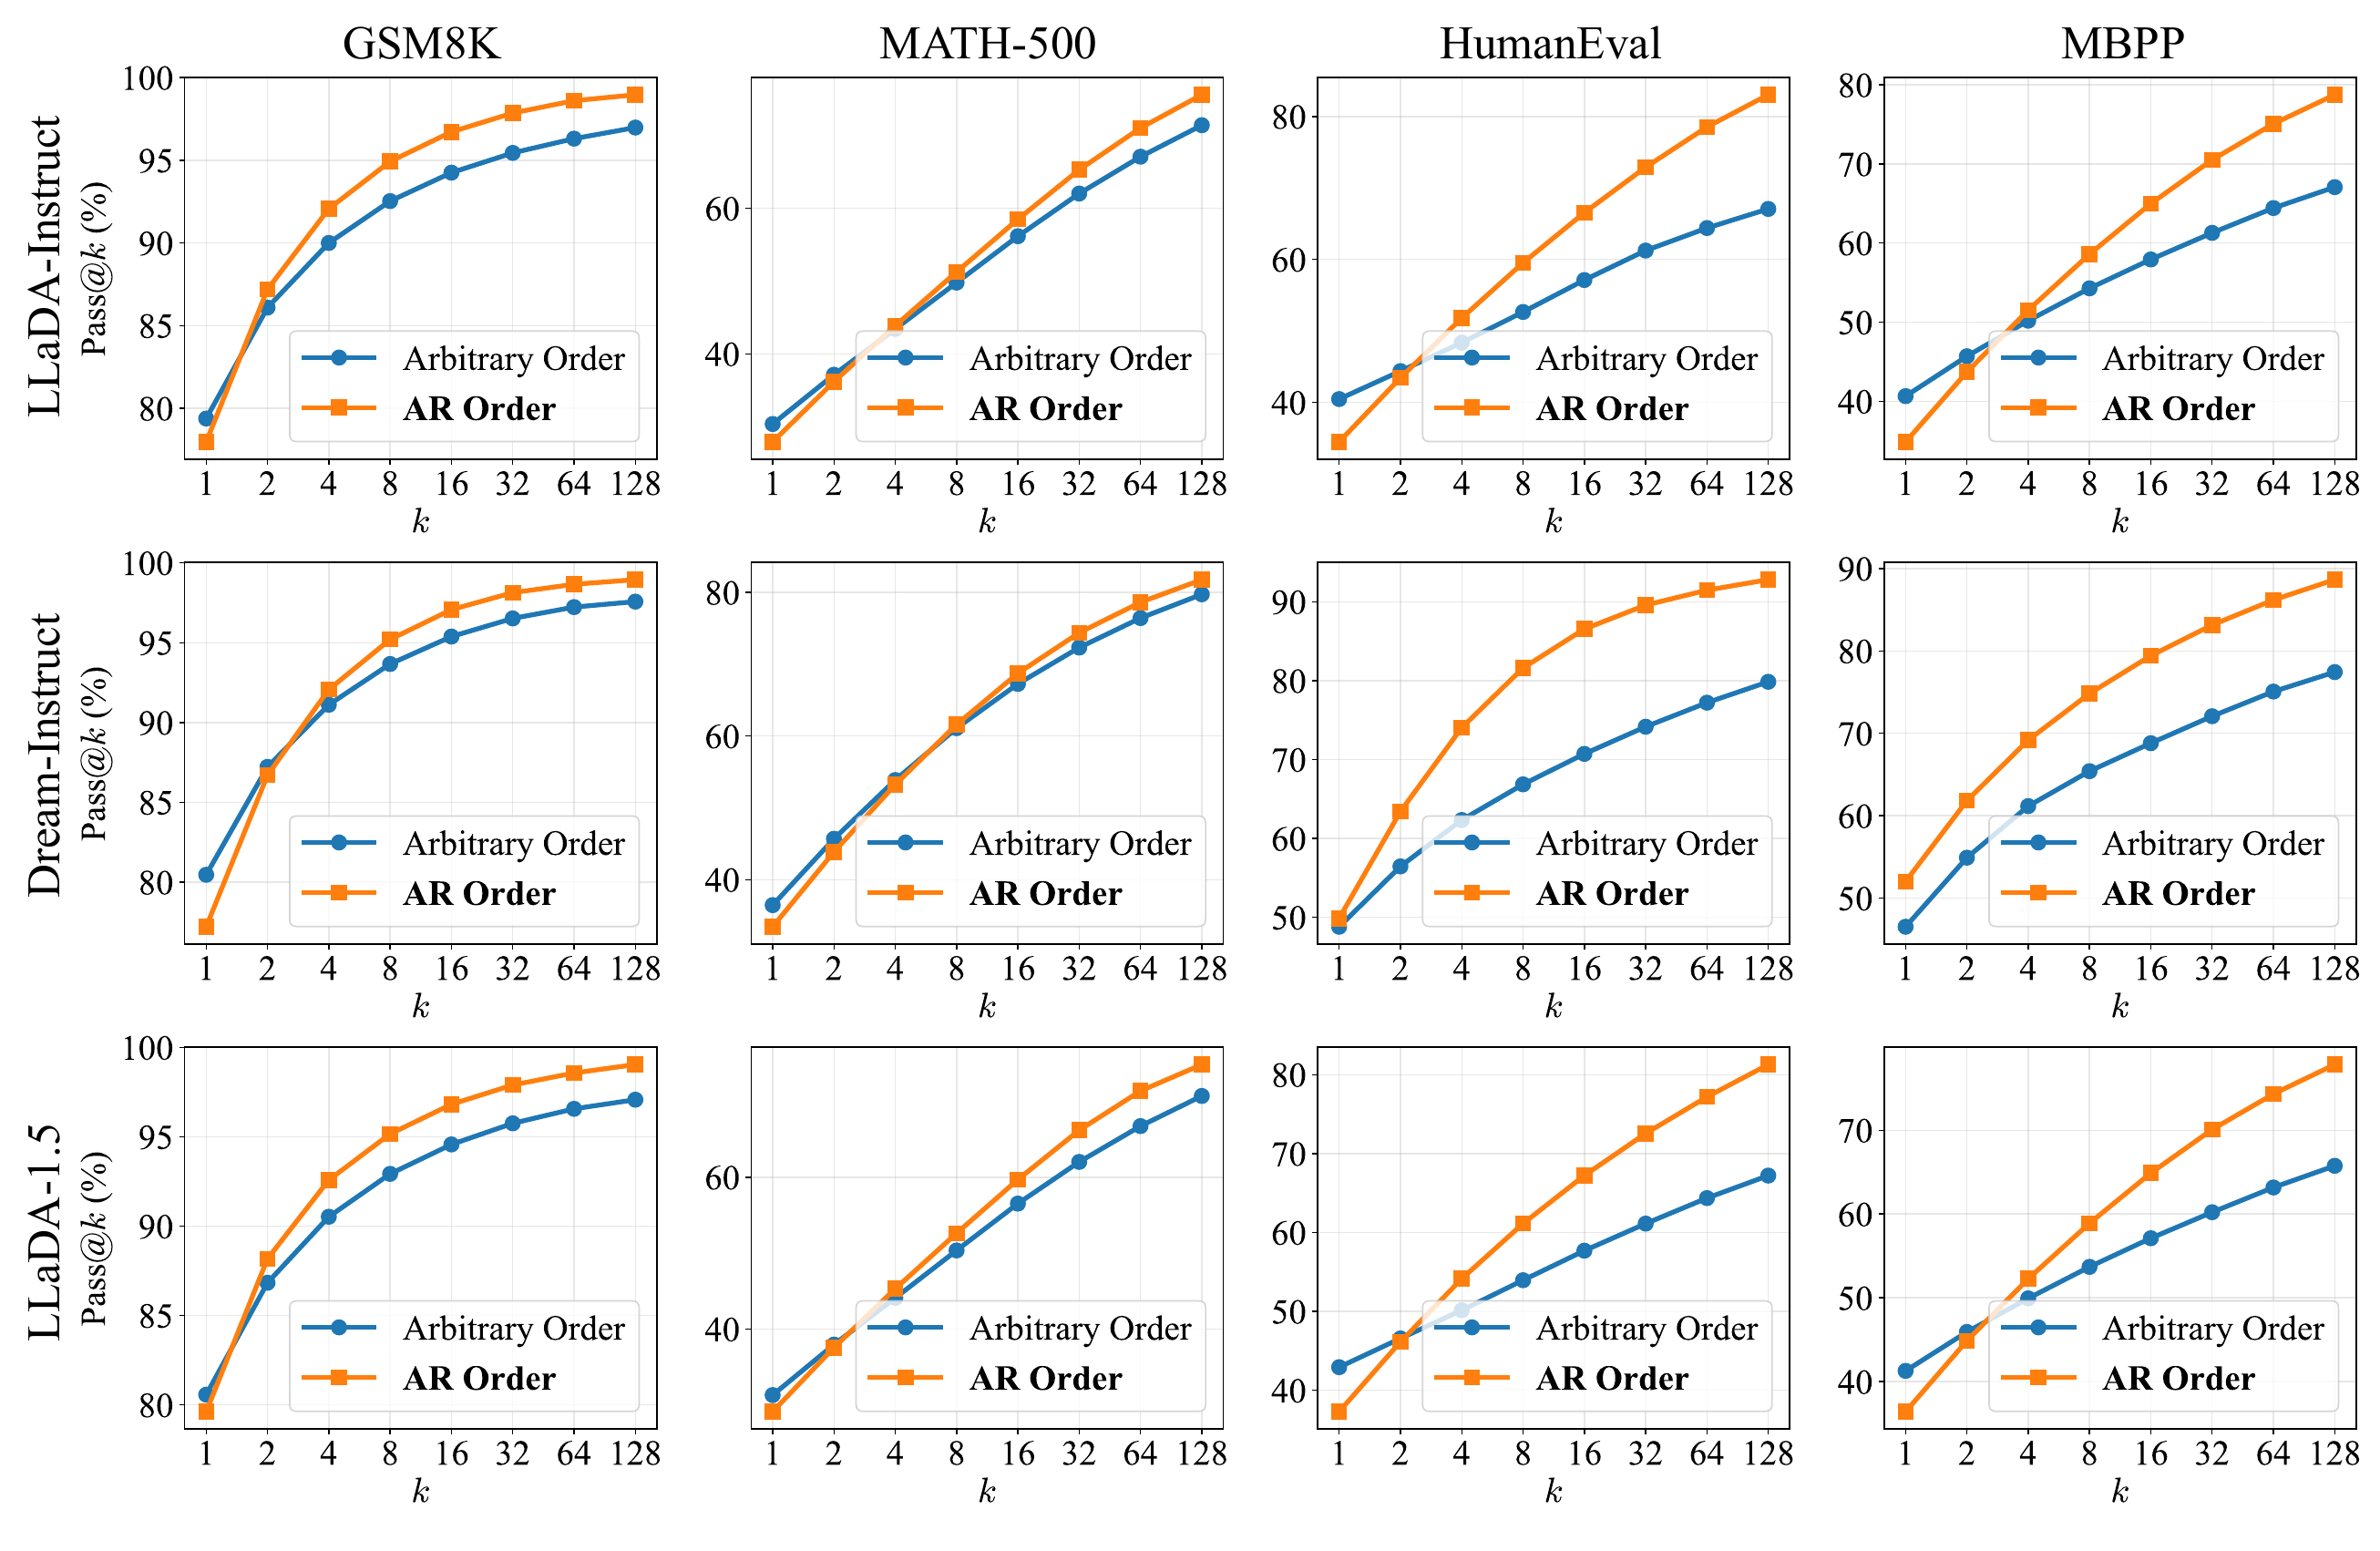
이 결과는 꽤 중요하다. RLVR은 모델이 우연히라도 맞는 풀이를 샘플링해야 그 경로에 보상을 줄 수 있다. Pass@1이 괜찮아 보여도 Pass@k가 일찍 평평해진다면, 학습이 강화할 새로운 정답 경로가 부족하다는 뜻이다.
실험 2: 다른 풀이를 찾는 것도 아니었다
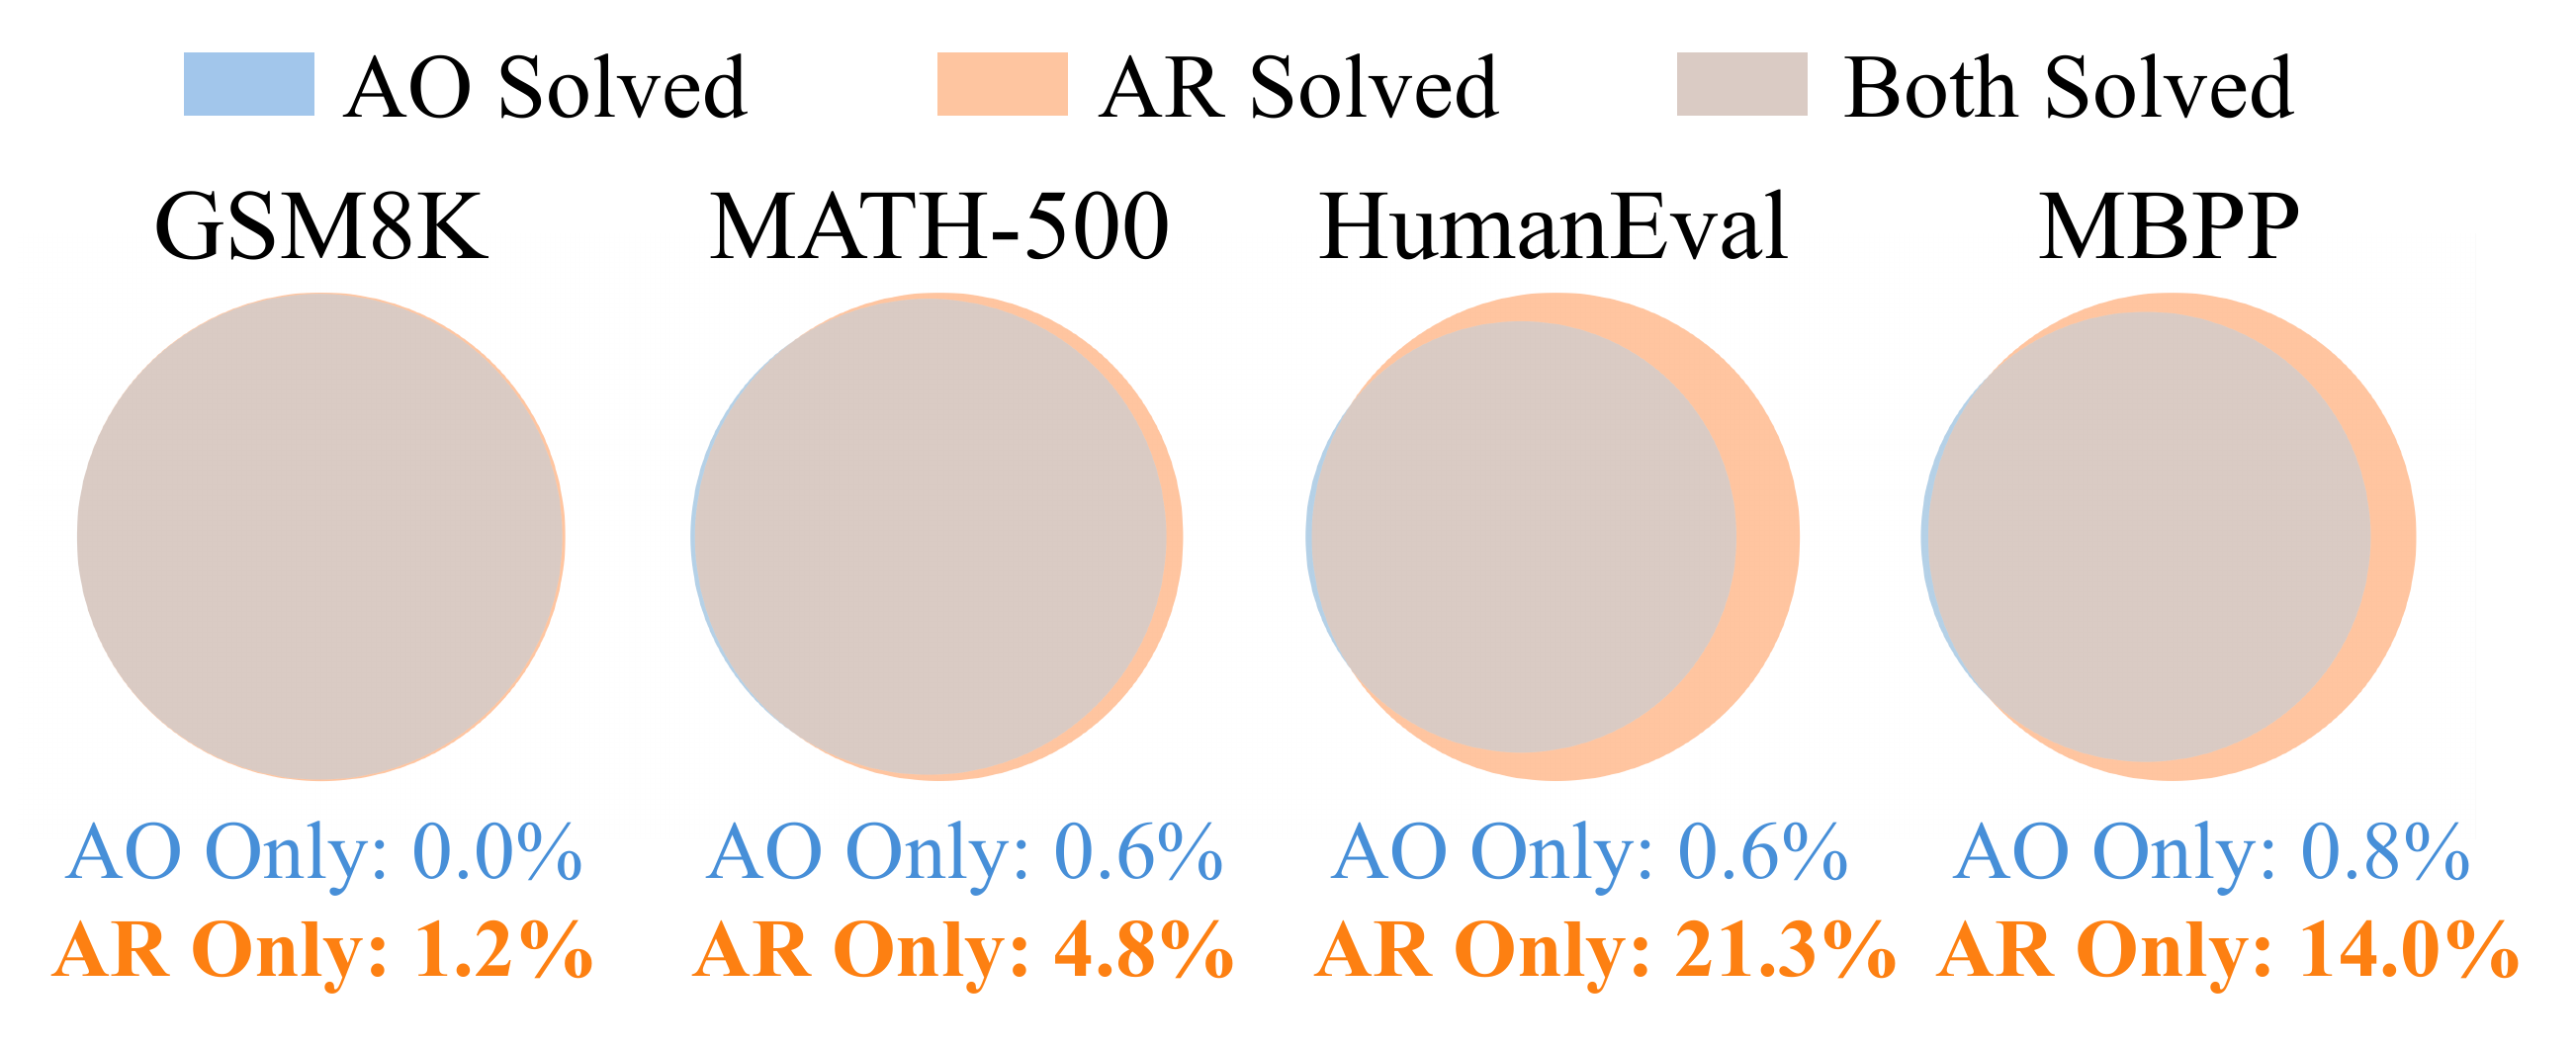
“AO가 적게 풀지만 AR과는 다른 독창적인 문제를 푸는 것 아닐까?” 저자들은 k=1024까지 샘플링해 두 방식의 solution coverage를 비교했다. 결과는 AO가 찾은 풀이 대부분이 AR 풀이 공간의 부분집합에 가까웠다. HumanEval에서는 AR만 해결한 문제가 21.3%였지만 AO만 해결한 문제는 0.6%였다.
왜 이런 일이 생겼을까: 어려운 결정을 나중으로 미루는 함정
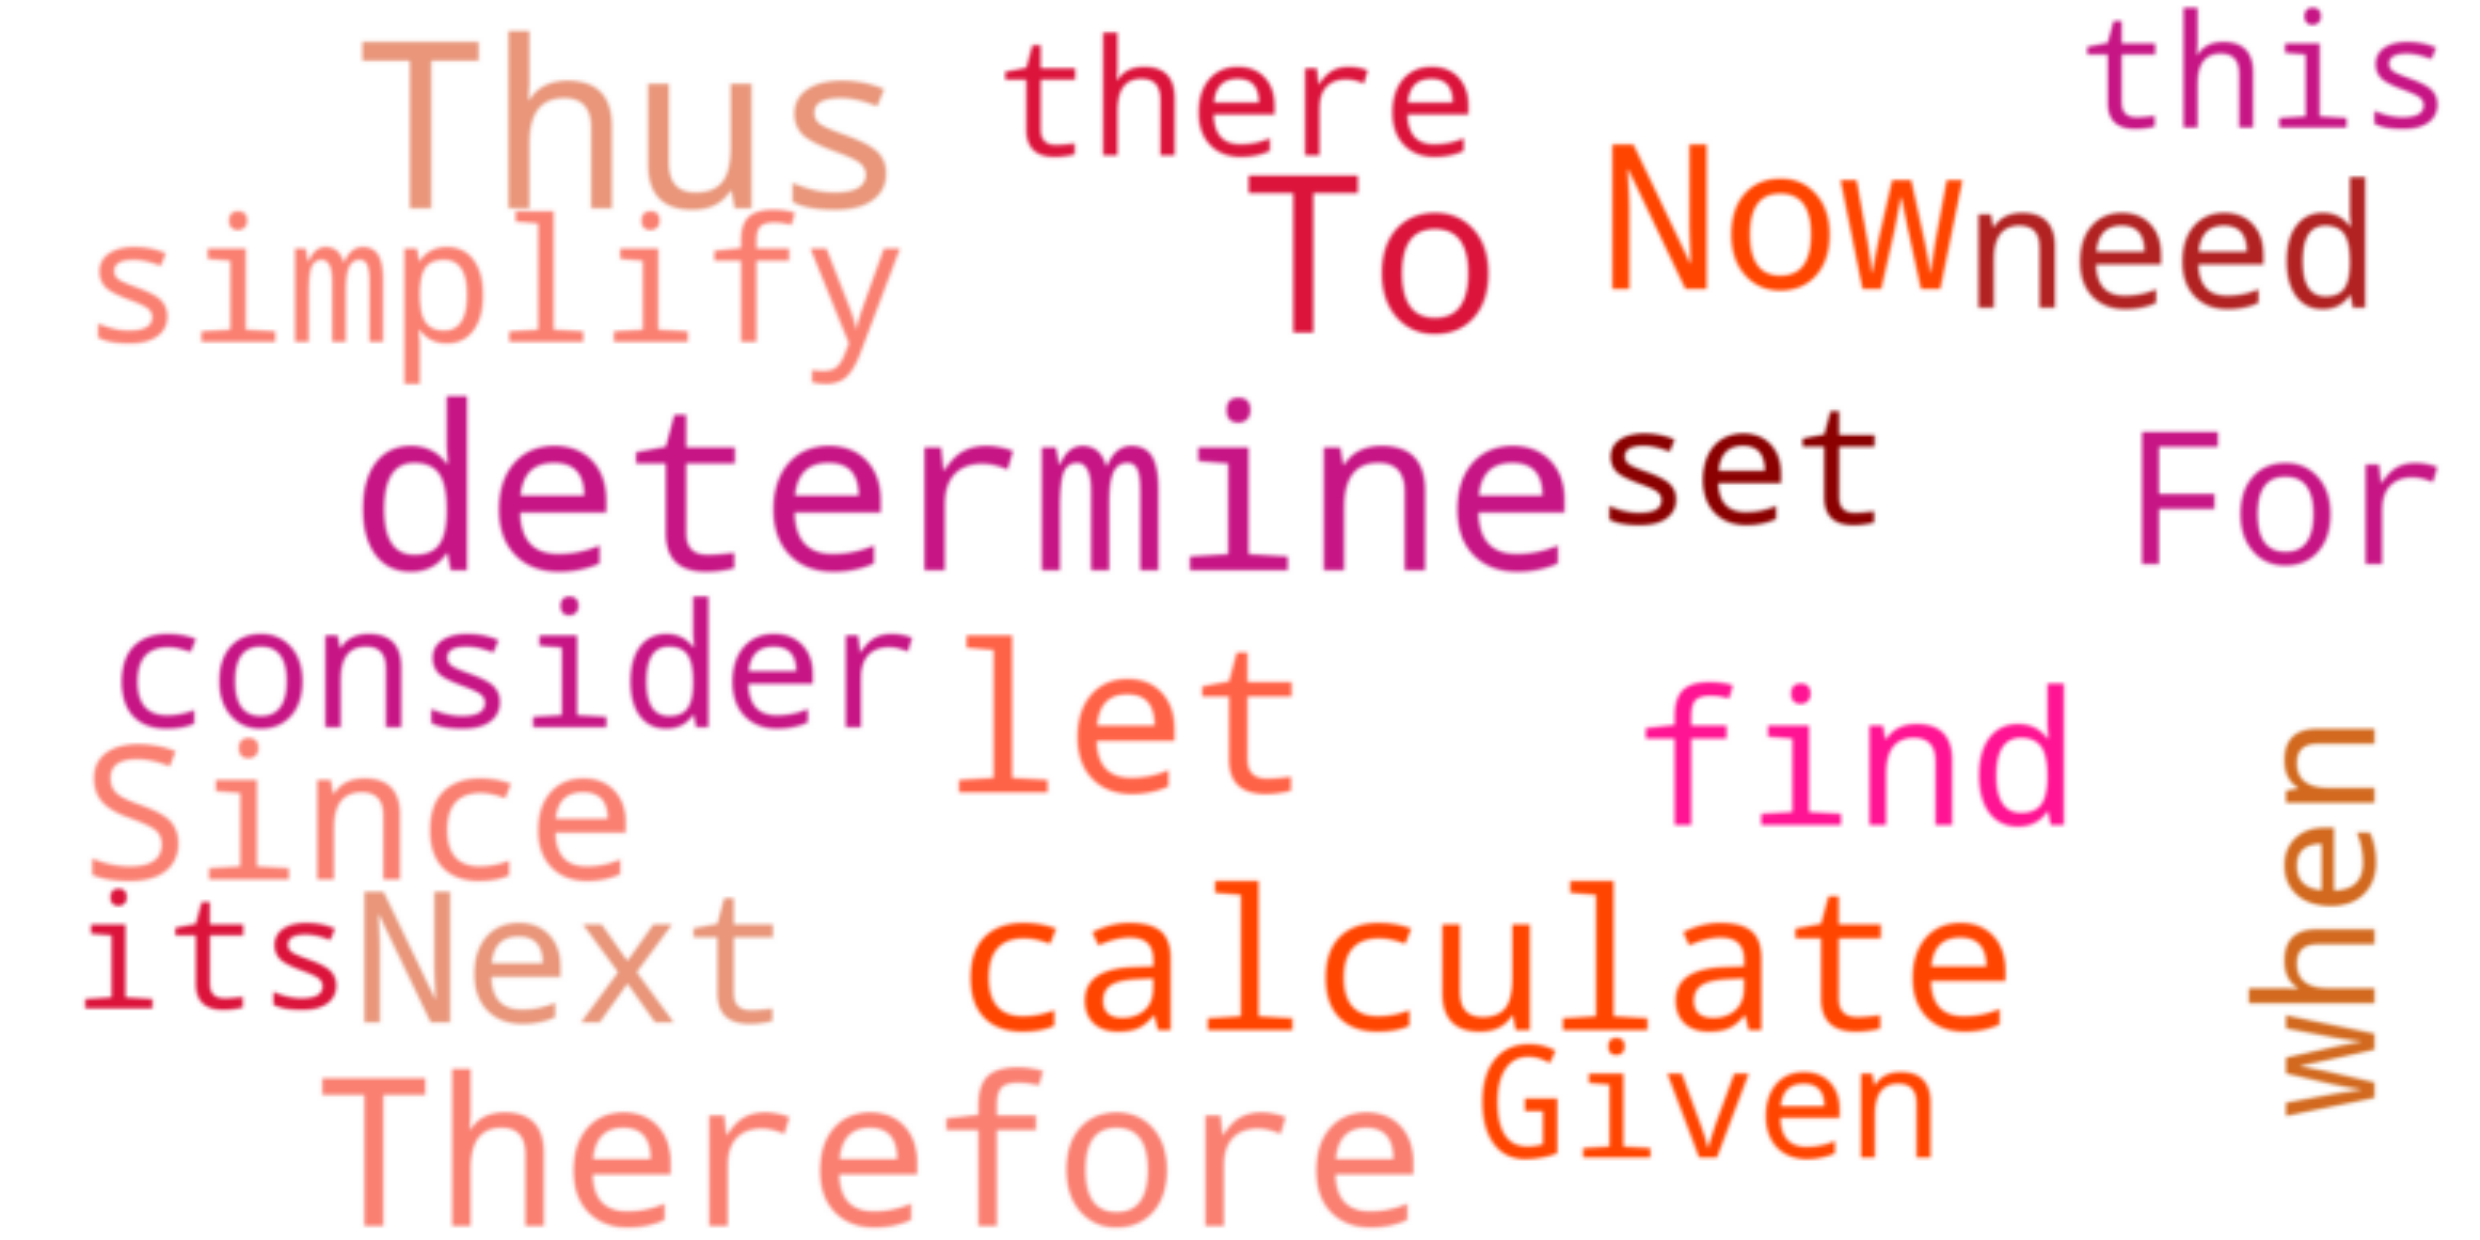
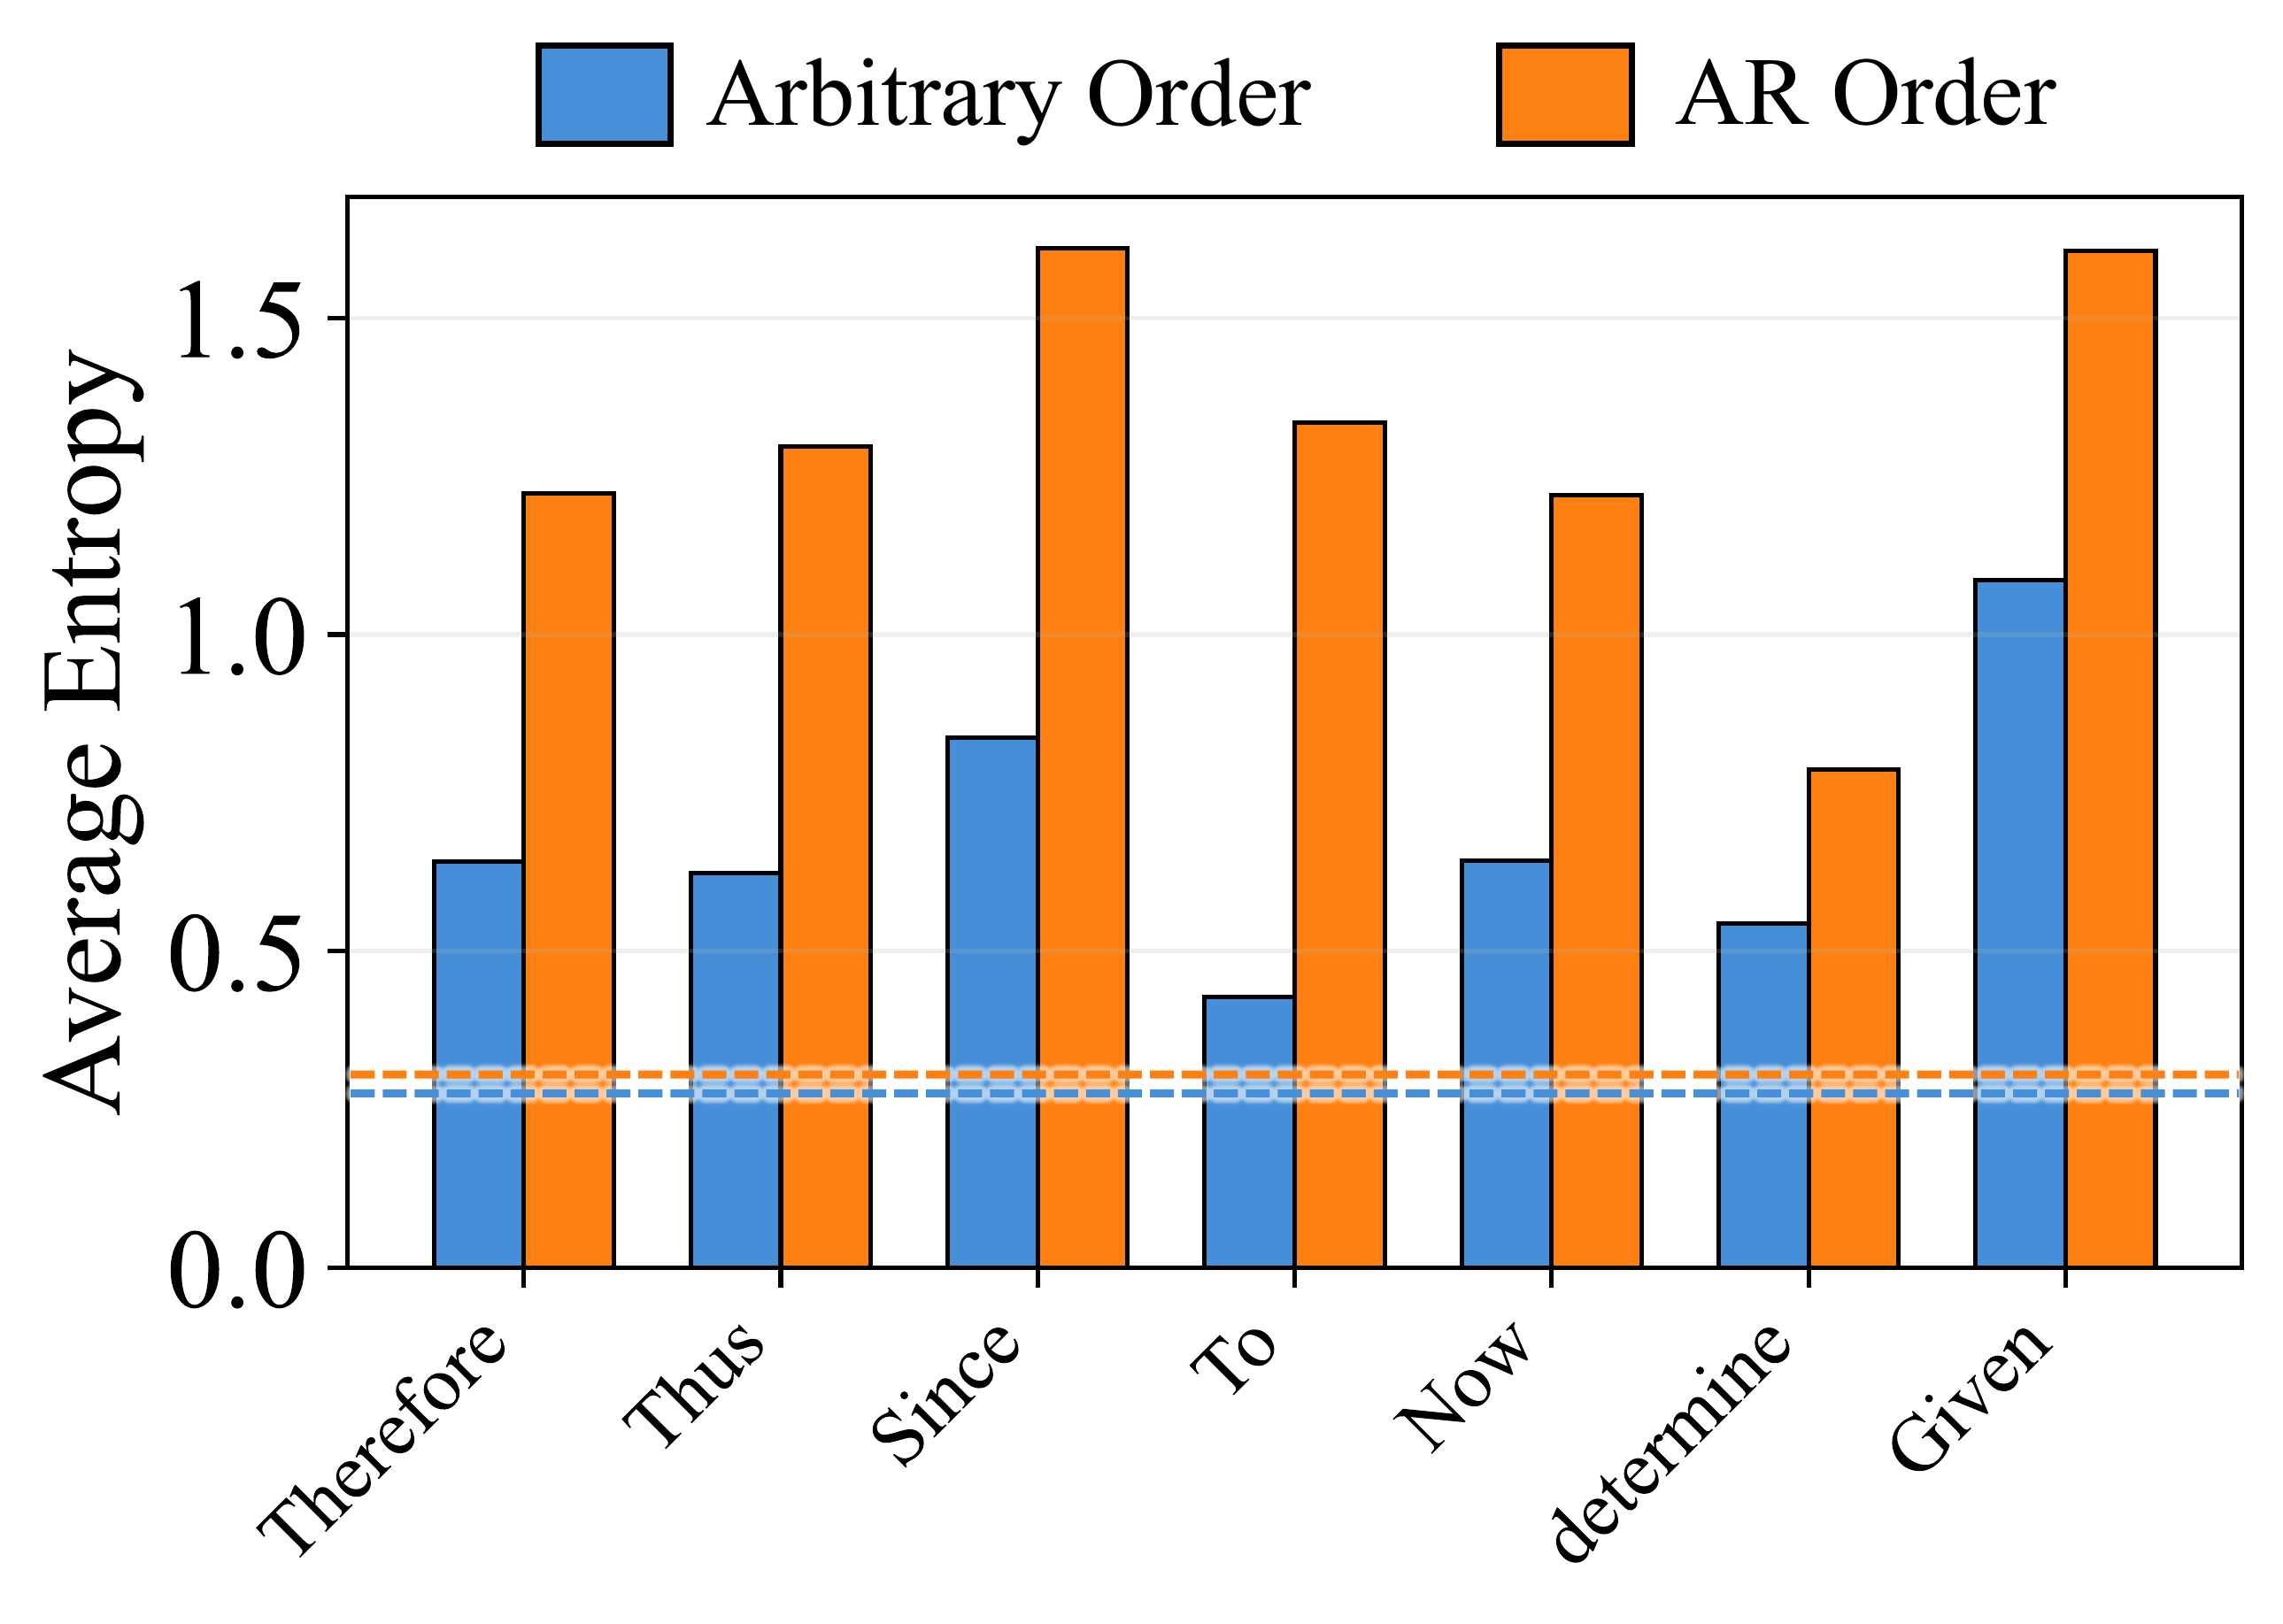
추론에는 방향이 갈리는 토큰이 있다. “따라서”, “하지만”, “왜냐하면”, 부호나 연산자처럼 뒤의 풀이를 바꾸는 토큰이다. 이런 지점은 여러 선택의 확률이 비슷해 entropy가 높다. AR 모델은 순서상 이 토큰을 만나면 지금 선택해야 한다. 잘못 갈 수도 있지만, 샘플을 여러 번 뽑으면 서로 다른 길을 탐색한다.
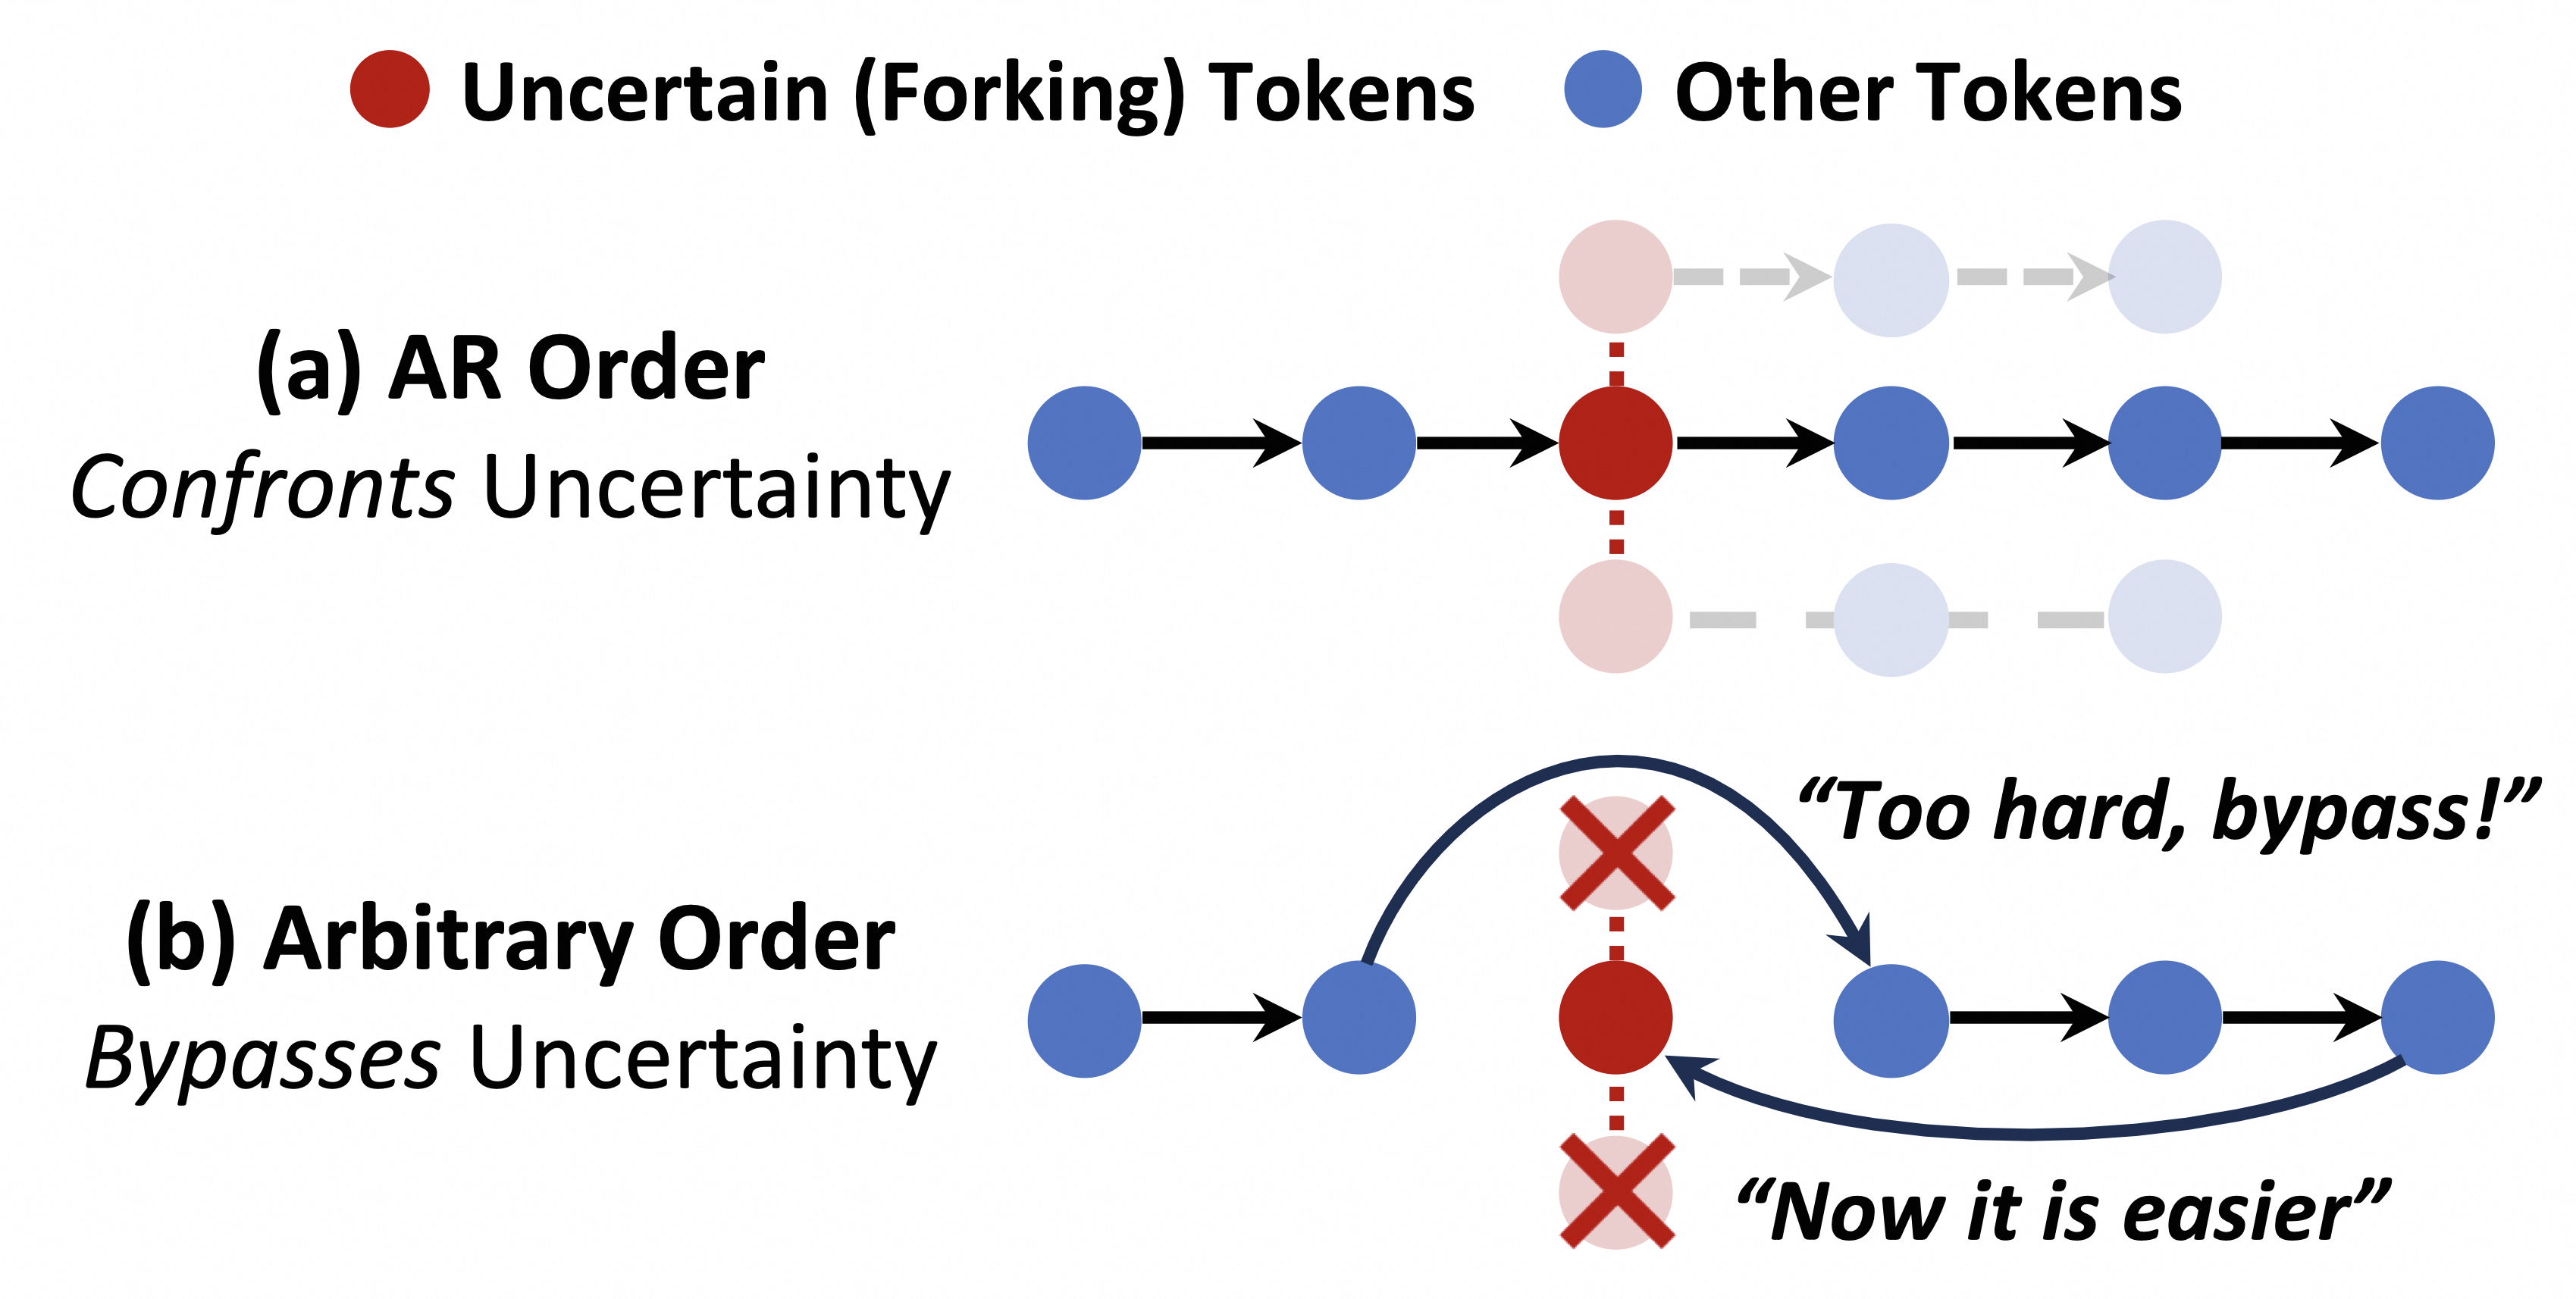
반면 confidence-based AO sampler는 가장 확실한 토큰부터 채운다. 어려운 갈림길을 비워둔 사이 그 뒤와 주변 문맥이 먼저 굳어진다. 나중에 돌아왔을 때는 가능한 선택이 이미 주변 문맥에 의해 좁아져 있다. 저자들은 이를 Entropy Degradation이라 부른다. 지역적으로 가장 자연스러운 문장을 만드는 exploitation이, 서로 다른 풀이를 시험하는 exploration을 잡아먹은 것이다.
해결책 JustGRPO: 학습할 때만 순서를 포기한다
dLLM에 RL을 적용하기 어려운 이유는 생성 경로가 조합적으로 폭발하기 때문이다. 길이 N의 토큰을 어떤 순서로 복원했는지까지 고려하면 trajectory 수는 O(N!)로 증가하고, 실제 confidence sampler와 학습 목적 사이의 mismatch도 생긴다.
저자들은 미래 위치를 모두 MASK로 두고 현재 위치의 확률만 AR policy로 정의한 뒤 표준 GRPO를 적용했다. 복잡한 diffusion 전용 RL 기법을 추가하지 않았는데도 LLaDA-Instruct 기반 실험에서 GSM8K 89.1%, MATH-500 45.1%를 기록했다. 기존 비교 방법 대비 각각 최대 3.0%p, 6.1%p 개선했다고 보고한다.
내 리뷰: 훌륭한 문제 제기지만, 아직 ‘AR의 승리’는 아니다
좋았던 점 1 — 평균 정확도보다 탐색 가능한 경계를 봤다
Pass@1만 비교했다면 두 방식이 비슷하다는 결론이 나왔을 수 있다. Pass@k와 solution overlap을 함께 봄으로써 RL이 실제로 활용할 수 있는 탐색 공간을 측정했다. 결과뿐 아니라 ‘왜 학습이 안 되는가’를 진단한 설계가 좋다.
좋았던 점 2 — 복잡성을 추가하지 않고 가정을 제거했다
AI 논문은 종종 문제 위에 새 모듈을 쌓는다. 이 논문은 arbitrary order를 보존해야 한다는 전제를 걷어내자 표준 GRPO로 문제가 단순해진다고 말한다. ICML이 강조한 것도 이 counter-intuitive하지만 구조적인 통찰이다.
한계 1 — ‘일반 추론’의 범위가 아직 좁다
평가는 수학·코딩 벤치마크 네 개와 dLLM 세 계열을 중심으로 한다. 문서 편집, 제약 충족, 계획 수정처럼 양방향 문맥이 본질적으로 유리한 과제에서도 같은 결론이 유지되는지는 별도 문제다. 저자도 arbitrary order가 스도쿠·Zebra Puzzle 같은 구조화 과제에서 유용할 수 있음을 인정한다.
한계 2 — Pass@k가 곧 RL의 완전한 상한은 아니다
많은 샘플에서 정답을 한 번 찾는 능력은 중요한 proxy지만, 실제 학습은 확률 질량, reward 분포, 학습 안정성, 데이터 다양성의 영향도 받는다. k=1024의 탐색 우위가 같은 비율의 운영 성능 향상으로 이어진다고 해석하면 안 된다.
한계 3 — 속도 이득은 Serving 조건과 함께 봐야 한다
학습은 AR rollout이므로 병렬 생성의 이점을 쓰지 못하고 비용이 커질 수 있다. 추론에서는 병렬 sampler를 유지하지만, 실제 속도는 denoising step 수, remasking, Cache 재사용, Batch와 하드웨어 커널에 따라 달라진다. “병렬 디코딩 가능”과 “end-to-end로 더 빠름”은 같은 문장이 아니다.
금융권 AI 엔지니어에게 어떤 의미가 있을까
당장 Azure OpenAI 기반 RAG를 dLLM으로 교체할 이유는 없다. 이 논문의 실무적 가치는 특정 모델보다 Agent와 평가를 설계하는 방식에 있다.
- 자유로운 Agent가 항상 더 잘 탐색하지 않는다. 쉬운 Tool부터 실행하는 confidence 기반 정책은 중요한 불확실한 결정을 뒤로 미뤄, 초기 가설을 굳힐 수 있다.
- 불확실한 fork를 관측해야 한다. 최종 성공률 외에 어떤 step에서 후보가 갈렸고, 재시도가 다른 경로를 탐색했는지 Trace diversity를 평가할 필요가 있다.
- 제약은 추론 품질을 높일 수 있다. 보험금 지급, 규정 해석처럼 순서와 근거가 중요한 업무에서는 자유로운 계획보다 승인된 workflow와 단계별 검증이 더 넓고 안전한 문제 해결을 만들 수 있다.
- 학습 정책과 Serving 정책을 분리할 수 있다. 안정적인 순서로 credit을 학습하면서 운영에서는 병렬화·캐시·라우팅을 최적화하는 train–serve asymmetry가 유효한 설계가 될 수 있다.
논문 및 자료
- 논문 — The Flexibility Trap: Why Arbitrary Order Limits Reasoning Potential in Diffusion Language Models
- 공식 프로젝트 페이지 — Figures, Model, Code
- 공식 코드 — JustGRPO
- ICML 2026 공식 Awards 발표
※ 논문의 arXiv 제목과 ICML 수상 발표에 기재된 camera-ready 제목은 표현이 일부 다르다. 본 리뷰의 수치와 주장은 arXiv v3 및 공식 프로젝트 페이지를 기준으로 정리했다. 논문 그림은 해당 프로젝트 페이지의 공개 자료를 출처와 함께 사용했다.
'AI 논문 리뷰' 카테고리의 다른 글
| [AI 논문 리뷰] AI가 기억을 너무 잘하면 왜 위험할까? — Agent Memory는 ‘저장’보다 ‘망각’이 어렵다 (0) | 2026.09.06 |
|---|---|
| [AI 논문 리뷰] LLM에게 ‘그것만 잊고 나머지는 그대로 기억해’라고 할 수 있을까? (0) | 2026.09.04 |
| [AI 논문 리뷰] 이번 ICML 논문 원픽이었던 - AI가 위키를 직접 쓰기 시작했다! LLM-Wiki 논문 리뷰 (1) | 2026.09.04 |
| [AI 논문 리뷰] Atlas: 사진 몇 장으로 3D 세계를 통째로 만드는 World Model (0) | 2026.09.03 |